





Débora I. Burin
1. Perspectiva lingüística: el lenguaje como sistema formal estructurado
Desde el sentido común hablamos de “lenguaje” para referirnos a una forma de conducta y a la comunicación: el lenguaje de la cara, de los gestos, los lenguajes del amor, el lenguaje de la moda, lo que le dice su gatito o perrito… Sin embargo, el lenguaje es una capacidad o facultad mucho más compleja que otras conductas observables y un sistema de comunicación mucho más complejo que los de otras especies animales. Dentro de la lingüística, como disciplina científica encargada de estudiar el lenguaje, se separa el objeto de estudio lenguaje o lengua del habla, la conducta lingüística y la comunicación. El estudio del lenguaje puede hacerse desde la perspectiva estructural, los símbolos y sus relaciones formales, la perspectiva conductual, cómo una persona usa este sistema en su comportamiento, y la perspectiva comunicacional, para qué sirve y cómo se usa entre varios hablantes en contexto (Belinchon et al., 1992). En otra descripción (Gallego, 1995), se analizan las relaciones entre signos, el nivel formal y sintáctico, las relaciones entre los signos con su referencia o significado, el nivel semántico y las relaciones entre usuarios a nivel pragmático. El foco de estudio de la lingüística estructural (De Saussure, 1985) radica en describir aspectos estructurales de este objeto de estudio y las reglas que rigen la combinatoria formal de sus elementos. Los otros aspectos del lenguaje tienen su correlato en otras áreas de estudio de la lingüística, como la semántica o la pragmática, y en disciplinas que combinan la lingüística con la psicología o la sociología; más adelante se abordará en particular la psicolingüística. Pero antes conviene entender la complejidad estructural del lenguaje.
La lingüística estudia los elementos formales que constituyen una lengua y las reglas que rigen las relaciones entre esos elementos (Belinchon et al., 1992; Cuetos et al., 2015; Gallego, 1995; Gibson, 2025). Desde la perspectiva estructural inaugurada por Ferdinand de Saussure a principios del siglo XX, se toma al lenguaje como un sistema o estructura, que tiene elementos formales arbitrarios y combinaciones de esos elementos formales siguiendo un sistema de reglas (De Saussure, 1985). Otra de las características definitorias del lenguaje es que la relación entre los elementos formales, los significantes, y el significado al que refieren es arbitraria; la relación entre los símbolos formales que constituyen una lengua y el significado a que refieren es convencional, depende de una convención arbitraria en cierta lengua. Por ejemplo, no hay nada en la palabra “caballo” (castellano) o “horse” (inglés) que refiera al objeto caballo.
Entonces, desde la perspectiva estructural se define el lenguaje como un sistema formal estructurado que consiste en un conjunto de unidades lingüísticas y un conjunto de reglas que permiten ir combinando estas unidades progresivamente en unidades mayores, para transmitir significado (Gallego, 1995). Cada lengua y, a un nivel muy abstracto, el lenguaje en general, tiene varios niveles de estructuración y en cada nivel hay unidades y reglas de combinación. El significado se va construyendo en varios niveles.
| Nivel | Unidad | Descripción |
| Fonológico | Fonemas | Unidades mínimas de sonido sin significado pero con capacidad distintiva. |
| Léxico | Palabras | Combinación de fonemas que crean unidades con significado (lexemas y morfemas) |
| Sintáctico | Oraciones | Combinación de palabras que expresan una idea completa siguiendo reglas gramaticales |
| Pragmático | Discurso | Conjunto de oraciones con coherencia y un propósito comunicativo en un contexto |
Figura 1. Niveles de estructuración del lenguaje.
En el primer nivel están los “átomos”, las unidades menores; en el fondo, cada lengua es una combinación particular de sonidos con valor lingüístico, que llamamos fonemas. Los fonemas son la mínima unidad sin significado de una lengua en particular (Cuetos et al., 2015; Gibson, 2025). Todas las lenguas tienen su conjunto válido de fonemas; por ejemplo, el castellano tiene 24 fonemas, 5 vocales más 19 consonantes, pero esta cifra varía en las diferentes lenguas, siendo lo típico (para el 70 % de las lenguas) entre 20 y 37 fonemas (Cuetos et al., 2015). La escritura, que a diferencia del habla natural es una invención humana posterior, no siempre refleja los fonemas, no hay una correspondencia exacta entre las letras escritas y los fonemas. Por ejemplo, en el castellano rioplatense la “c” suena como “s” /s/ cuando se combina con “e” o “i”; en inglés la secuencia “oo” es /ʌ/ en “blood” y /u/ en “mood”.
Cada lengua tiene un primer conjunto de reglas para ir combinando los fonemas en unidades mayores, que son las palabras. El siguiente componente en la jerarquía del lenguaje está constituido por las palabras, que son las unidades más pequeñas con significado (Cuetos et al., 2015; Gibson, 2025). Las palabras son relaciones organizadas entre elementos fonológicos y conceptuales (de significado). Más adelante se tratará el amplísimo tema del significado, que incluye aspectos no estrictamente lingüísticos. Las palabras se componen de varias partes, llamadas morfemas. Los morfemas pueden constituir palabras por sí mismos (p. ej. “yo”) o ser apéndices de otras palabras (p. ej., la -s de “gatos”, la a- de “anormal”). El lexema es la raíz, la parte de la palabra que refiere a un aspecto central de significado, al que se le pueden agregar otros morfemas como prefijos y sufijos (cómo empieza y cómo termina la palabra), que pueden indicar nuevas palabras o variaciones gramaticales. Por ejemplo, “larg—” es la raíz, el lexema, y puede tener distintas flexiones según género, número (“largos”, “larga”) o si es adjetivo (“alargado”) o verbo (“alargar”) y sus variaciones en tiempo y persona.
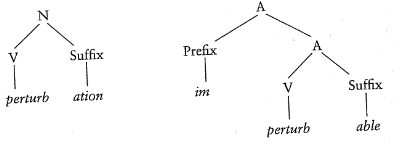
Figura 2. Ejemplo de composición de la palabra “imperturbable” (Jackendoff, 2002).
- El conjunto de reglas para cómo hacer palabras con fonemas no es al azar y no es infinito: es un conjunto concreto para cada lengua. Por ejemplo, en castellano, la secuencia típica es consonante-vocal-consonante-vocal; cuando hay dos consonantes seguidas que empiezan una palabra, hay cadenas legales e ilegales, por ejemplo “ññ” o “tm” no podrían empezar palabras en castellano (salvo quizás interjecciones); en estos casos, cuando una palabra empieza con “ñ” puede seguir una vocal pero no una consonante; cuando empieza con “t” puede seguir vocal o “r”, y así. Hay reglas (fonotácticas) que describen las cadenas legales e ilegales y hay otras reglas (morfológicas) que dicen cómo se forman las posibles categorías de palabras, categorías gramaticales (sustantivo, verbo, adjetivo, artículo, pronombre…). En general las categorías gramaticales se forman con elementos que van al principio (prefijo) o al final (sufijo), pero también en medio de la palabra. Por ejemplo, si termina en “-ar”, “-er”, “-ir”, es un verbo en infinitivo; si es un verbo conjugado, tiene distintas formas de terminar de acuerdo con tiempo y número. Si es un sustantivo común, puede terminar en -a, -o, -e, -n, etc. Si es un diminutivo, se forma con -ito, -ita. Cada lengua tiene reglas para cómo hacer con las unidades menores (fonemas), con las unidades mayores (palabras), y así transmitir significado.
Estas reglas definen cuáles son las cadenas legales e ilegales y, además de eso, las combinaciones de fonemas que indican categorías gramaticales. Para cada lengua hay un conjunto de reglas finito (= no infinito), discreto. En el caso del castellano, la Real Academia Española se encargó de escribir estas reglas que indican cómo hacer palabras a partir de fonemas.
Además de estas reglas para pasar de los fonemas a las palabras, hay un segundo conjunto de reglas que indican cómo pasar de las palabras a las oraciones, cómo transmitir relaciones entre conceptos. La relación entre los conceptos (las proposiciones) se implementa en el lenguaje mediante las oraciones. Por ejemplo, imagine esto mismo que está leyendo, pero como una serie de palabras aisladas: “lenguaje, Saussure, lingüística, perspectiva, unidad mínima, oración, significado…”. No es algo que tenga sentido. La forma de transmitir conjuntos de ideas, relaciones entre conceptos, es mediante la oración. Las oraciones constituyen la verdadera unidad de significado del lenguaje humano (Chomsky, 1959; Cuetos et al., 2015; Gibson, 2025). Hay una idea de sentido común que reduce la problemática del lenguaje a la asociación entre un significante (una palabra) y un significado, pero esta es una idea incorrecta. De hecho, un gato o un perro doméstico seguramente asocia una palabra, o un tono de voz, o un sonido con comida. Los animales pueden aprender asociaciones entre un significante (palabra, tono, sonido) y un evento ambiental como significado (comida). Lo que no pueden es entender variaciones de una oración.
En la oración, el significado es global y depende de la combinación específica de las palabras, lo que se llama composicionalidad (Gibson, 2025). Por ejemplo, con las mismas palabras, no es lo mismo “Juan le dio el libro a Pedro” que “Pedro le dio el libro a Juan”. Una oración, en todas las lenguas, tiene una estructura compleja que puede representarse como un gráfico en forma de árbol, que muestra las dependencias entre las palabras (Gibson, 2025). Entre otras reglas y dependencias, se destaca que la mayoría de las oraciones tienen en el centro una acción o un estado, lo cual es indicado por un verbo. Este verbo tiene en general un agente (quién hace) y muchas veces un objeto (a qué o a quién), y cada uno de estos tiene modificadores. En las sintaxis más tradicionales se analiza la oración en términos de un sintagma nominal y un sintagma verbal (que en la escuela se llamaban sujeto y predicado). El núcleo del sintagma nominal es uno o varios sustantivos, que llevan sus modificadores como artículos, adjetivos, etc. El sintagma verbal o predicado consta generalmente de uno o varios verbos y todos los complementos de tiempo, de lugar. Tanto el sujeto como el predicado pueden tener oraciones subordinadas, una oración incrustada dentro de otra (por ejemplo: “[El libro <que vos me regalaste> está buenísimo]”). La figura 3 muestra ejemplos de cómo se grafica la composicionalidad.
Así, cada lengua en particular tiene un conjunto discreto, finito, de reglas para cómo hacer oraciones a partir de palabras. Son las reglas sintácticas, combinadas con reglas morfológicas (Gibson, 2025). Por ejemplo, en castellano, para indicar el objeto directo, no cambiamos la forma de las palabras; en latín, alemán y otros idiomas, algunas palabras cambian según sean parte del sujeto o del objeto directo.
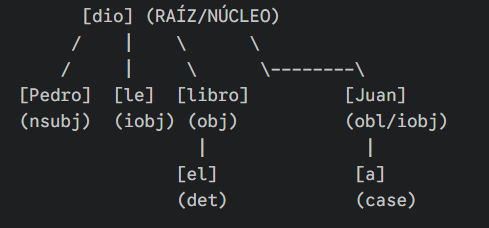
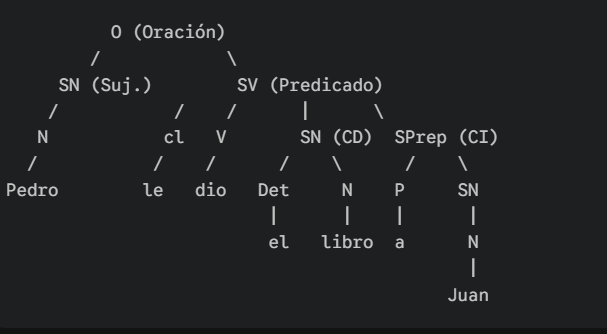
Figura 3. Dos formas de representación de la estructura sintáctica: árbol de dependencias (izquierda) y estructura de constituyentes (derecha).
Resumiendo: el lenguaje es un sistema compuesto por un conjunto de unidades formales y arbitrarias, que se van combinando según reglas formales en niveles superiores de estructuración, para transmitir significado. Es la doble articulación del lenguaje: doble sistema de reglas, uno para pasar de fonemas a palabras y otro para pasar de palabras a oraciones (Cuetos et al., 2015). La gramática es el sistema general de reglas de un idioma, incluyendo morfología (estructura de palabras) y sintaxis (Gibson, 2025).
Por último, los seres humanos no hablamos en oraciones aisladas, sino que combinamos oraciones en lo que se llama discurso. El discurso, en lingüística, se refiere a un conjunto coherente de oraciones. Por ejemplo, el discurso de un paciente, la narración de una película, una clase, lo que dice alguien en un posteo de red social o video o podcast, todo eso se denomina “discurso”. Consta de varias oraciones con un sentido global y coherencia. En este nivel, si bien se describen algunas reglas de cohesión, intervienen también aspectos semánticos y pragmáticos, que convocan a sistemas neurocognitivos tanto lingüísticos como extralingüísticos, distintos sistemas de memoria, de teoría de la mente, espaciales… (Casto et al., 2025; Jackendoff, 2002, véase el apartado sobre procesamiento a nivel de texto y discurso).
2. Diferencias entre el lenguaje y otros códigos comunicacionales
Como se puede apreciar, el lenguaje es un sistema altamente complejo y no se reduce a la problemática de con qué significado se asocia una palabra ni a una conducta entendida como respuestas verbales por parte del conductismo (Belinchon et al., 1992; Cuetos et al., 2015). Hay muchas formas de comunicación y el lenguaje es un sistema distinto a otras formas de comunicación como los gestos, el lenguaje no verbal, la comunicación animal, los colores del semáforo, la moda y la ropa, la música… Por otro lado, hay otros lenguajes que son artificiales, como la lógica, los lenguajes de programación, la notación musical, que se basan en el lenguaje natural humano y heredan sus propiedades especiales. ¿Cuáles son estas propiedades especiales? ¿Qué diferencia al lenguaje humano de los otros sistemas comunicacionales? Muchos investigadores propusieron listas de características distintivas del lenguaje humano; por ejemplo, es muy conocida la de Hockett, quien propuso trece propiedades o rasgos característicos (Gallego, 1995; Cuetos et al., 2015). Sin embargo, Cuetos et al. (2015) señalan las tres siguientes como características más distintivas:
2.1. Referencia simbólica arbitraria
La primera característica, ya señalada por De Saussure, es que no hay nada en el significante, no hay nada en el conjunto de sonidos que componen, que remita a la idea que transmite. Es un sistema simbólico y la relación con el significado es arbitraria, una convención dentro de una lengua. No hay nada en las palabras “hambre” (castellano), “sult” (noruego), “սով” (armenio), “głód” (polaco) que remita al hecho de tener hambre, mientras que los otros códigos comunicacionales tienen una relación de ícono o índice. Ícono significa que se parece a lo que representa; por ejemplo, el ícono de “tacho de basura” para borrar en la computadora, los carteles que señalan si un baño es de hombre o mujer. Índice significa que el símbolo tiene contigüidad con el contexto, el índice “apunta” hacia algo porque es una consecuencia o parte de ello; se completa con el contexto o lo entendemos porque remite a un contexto de donde salió. Por ejemplo, en la comunicación de los bebés, cuando señalan hacia algo y ponen cierta cara, o cuando un gatito o un perrito dice “miau” o “guau”, en ambos casos, para entender qué significa miramos dónde está y otros indicios en su expresión facial, postura y en otras situaciones similares.
2.2. Doble articulación
Se refiere al doble conjunto de reglas descritas antes: de los fonemas a las palabras, y de las palabras a oraciones (véase el apartado 1). Con un conjunto reducido de fonemas y un primer conjunto de reglas se pueden formar palabras, y con un segundo conjunto de reglas se pueden formar oraciones. Esta es una característica que no tienen otros códigos comunicacionales, que en general consisten en un conjunto fijo de elementos que no son combinables, no están sujetos a una combinatoria formal de elementos. Por ejemplo, en la comunicación animal, no se combinan distintos tipos de miau o de guau para decir distintas cosas, sino que en general hay una forma particular de sonido para indicar hambre, dolor, satisfacción o felicidad, para llamar, para salir…, y es el contexto el que nos da la idea de qué es lo que nos quiere decir. Otro ejemplo es la expresión emocional mediante el rostro en humanos; las emociones se transmiten en formato no verbal, con caras y gestos. Pero esta no es una combinatoria formal, es una comunicación holística, global, de un conjunto pequeño de estados emocionales básicos; lo que le agrega matices, gradación, es la posibilidad de expresar mediante el lenguaje.
2.3. Productividad y creatividad
Debido a las dos características anteriores, la arbitrariedad y la doble estructura, el lenguaje humano puede expresar, y crear, infinitas palabras y oraciones nuevas. Debido a la arbitrariedad del signo, que libera al lenguaje de la semejanza o contigüidad con lo que representa, y a la doble estructura, que permite partir de un número muy pequeño de unidades y una serie de reglas para formar infinitas oraciones, el lenguaje es infinitamente creativo y productivo. Esto permite expresar y comprender infinitas ideas. Siempre se pueden inventar palabras nuevas para referirse a cosas ya existentes o nuevas, siempre se puede crear una oración nueva sobre algo. A diferencia de otros códigos comunicacionales que son un conjunto cerrado de unidades que se refieren a un conjunto discreto de ideas: estados, acciones o características del contexto, el lenguaje permite hablar sobre entidades, estados o situaciones abstractas, imaginarias o hipotéticas, por ejemplo, de lo que podría haber sucedido en los inicios de la humanidad, de la existencia de Dios, de qué pasaría si cambiara de carrera o de país o de qué es un país.
Dentro de la productividad y creatividad se incluye una característica formal, estructural, del lenguaje que es la recursividad, es decir, la posibilidad de insertar una oración dentro de otra oración. Las reglas para formar oraciones contemplan que alguno de sus constituyentes esté formado, a su vez, por otra oración. Por ejemplo: “el perro que Lucía vio en la calle era un caniche”: hay una oración principal, “el perro era un caniche”, y otra que califica al núcleo del sintagma nominal o sujeto (“perro”). El núcleo del sintagma nominal o sujeto de la segunda es “Lucía” y el verbo, “vio”. La recursividad es técnicamente infinita; por ejemplo, con base en la oración anterior, “Emilia cree que el perro que Lucía vio en la calle era un caniche”, “Juan dijo que Emilia cree que el perro que Lucía vio en la calle era un caniche”, “Me parece que Juan dijo que Emilia cree que el perro que Lucía vio en la calle era un caniche”… De esta manera, a las millones de combinaciones de palabras en oraciones se añade esta posibilidad, que vuelve al lenguaje una combinatoria con infinitos resultados.
Como herramienta semiótica, es radicalmente distinta de los otros códigos comunicacionales, ya que permite diferenciar planos de enunciación (quién dice qué). Por ejemplo, imagínese que alguien perdió un perrito caniche y le dicen que “Juan dijo que Emilia cree que el perro que Lucía vio en la calle era un caniche”. ¿Es cierto que Lucía lo vio? Podría ser cierto que Juan dijera eso y que Emilia creyera eso, pero falso que Lucía vio un caniche en la calle. O puede ser cierto que Lucía vio, pero que Emilia crea eso, o puede ser cierto lo de Lucía y Emilia pero no lo de Juan. La recursividad permite diferenciar planos de enunciación y de significado. Ningún otro código comunicacional puede hacer esto, comunican algo directamente, ningún perrito o gatito puede expresar: “Vos creés que yo quiero comer”. Nótese que todos los verbos mentalistas (creer, sentir, decir…), la capacidad de entender que se refiere a la actividad de una mente que puede ser distinta de la propia (o de un estado de cosas en la realidad), se relacionan con la capacidad de expresar y entender oraciones con recursividad.
3. Funciones del lenguaje humano
Todos los seres humanos (si no hay trastornos graves o específicos) hablan y entienden al menos una lengua, incluyendo a las personas que lo hacen a través de lenguas de señas. Esta capacidad que tienen todas las personas, con sus características especiales, tiene importantes funciones en el ser humano. Si bien se han propuesto muchas funciones que cumple el lenguaje en la vida de las personas, se pueden identificar principalmente dos, asociadas (desde corrientes teóricas distantes) a la naturaleza sociocultural humana (Vigotsky, 1964) o al “nicho cognitivo” humano (Pinker, 2003): las de comunicación y representación del conocimiento, de las cuales se desprenden otras funciones.
3.1. Comunicación y conducta
El lenguaje permite un gran despliegue de sus aspectos funcionales, como herramienta en la comunicación y la interacción social. Muchos animales tienen gestos y vocalizaciones que emiten ante otros para referirse a objetos, acciones o hechos del contexto (función referencial), a estados emocionales o internos (función expresiva) y para pedir algo (función conativa), pero el lenguaje amplía infinitamente esta capacidad a situaciones no relacionadas con el contexto. Todos los seres humanos, de la sociedad y cultura que sean, hablan sobre cosas, personas o temas generales que no están presentes de forma inmediata en sus sentidos, o sobre el pasado o el futuro. En palabras del filósofo Bertrand Russell, “un perro no puede decirnos que sus padres eran pobres pero honrados” (Cuetos et al. 2015). La infinita variedad de significados que puede comunicar el lenguaje no tiene paralelo en el reino animal, ni en otros sistemas de comunicación (excepto, quizás, los basados en el lenguaje natural, que expanden la capacidad de lenguaje). El aspecto comunicacional del lenguaje en la interacción humana no solo implica informar, referir o expresar un estado interno, sino que también se puede orientar a modificar la conducta, a que suceda algo en otra persona o incluso en uno mismo, como herramienta de autorregulación. El lenguaje es la forma de comunicación por excelencia en nuestra especie, socialmente compleja y basada en el conocimiento y la cultura (Pinker, 2003; Vigotsky, 1964).
Una de las perspectivas de la función conductual del lenguaje es la del conductismo. Pone el acento en el lenguaje como habla, como parte del comportamiento. En dos aspectos fundamentales: primero, en el lenguaje en tanto conducta aprendida; segundo, en el papel del lenguaje en las interacciones conductuales. Para Pavlov, figura fundante del conductismo clásico, las palabras operan como “segundo sistema de señales” que permiten asociar y reemplazar un objeto y generalizar, mediante asociaciones por condicionamiento, a otras palabras y objetos o situaciones (García Vega, 1993). En la misma línea, para Skinner, la conducta verbal se origina y sostiene mediante condicionamiento operante, por las consecuencias ambientales que la refuerzan. Lo que interesa es la conducta verbal, como un repertorio de respuestas con valor funcional (Cuetos et al., 2015). Se enfoca sobre todo en la conducta entre personas, aunque también aborda la conducta verbal intrapersonal o “conducta privada”, es decir, el pensamiento, donde el hablante es también su propio oyente, que refuerza su conducta internamente.
Dentro de la función comunicativa, y desde otras perspectivas, se ha señalado que el lenguaje se emplea para la cognición social (Jackendoff, 2002). En primer lugar, mediante el lenguaje se conforma la cohesión y diferenciación social. Se usa el lenguaje para expresar la identidad grupal, con palabras o frases que señalan la pertenencia a un grupo. El léxico o las frases compartidas en una cultura o grupo social pueden crear lazos, señalizar pertenencia, identificar a quienes están “adentro” o “afuera”. Por ejemplo, frases como “aguante Boca”, que identifica a alguien como seguidor de ese equipo de fútbol, o las consignas políticas que unifican a los seguidores, o las palabras, frases o modos de hablar que van creando las diferentes generaciones de jóvenes y los subgrupos o “tribus”.
En las sociedades humanas el lenguaje además instituye hechos, los crea a la vez que los comunica (Austin, 1970; Jackendoff, 2002). La diferenciación social mediante roles formales (como “juez” o “heredero”) solo existe porque el lenguaje permite crear realidades abstractas que todos aceptan. Sin lenguaje, no hay forma de diferenciar a un individuo por su cargo o estatus legal más allá de la fuerza física. Las palabras de gobernantes, autoridades o personas en cargos institucionales formales e informales crean hechos sociales. Parte de la sociedad civil avanzada se basa en frases contractuales que instituyen hechos sociales. Por ejemplo, en un registro civil: “Acepta por esposo/a…”, “Sí, acepto…”, “Les declaro unidos en matrimonio”.
3.2. Representación conceptual
Una función específicamente humana del lenguaje es la de representación abstracta, formal, más allá de la experiencia sensible. El lenguaje está asociado a la capacidad conceptual. El lenguaje permite la codificación conceptual y proposicional de la experiencia (Cuetos et al., 2015; Pinker, 2003). Gracias al lenguaje, nuestro conocimiento puede ir más allá de instancias únicas y experiencias personales. La adquisición del lenguaje va de la mano con la formación de categorías y conceptos generales, concretos (p. ej. “animales”) y abstractos (p. ej. “equipo de fútbol”), y permite generar esquemas complejos de conocimiento, ideas asociadas y organizadas sobre ellos (“en el campeonato que empieza ahora vamos a sufrir, pero va a ganar mi equipo”, que supone un esquema sobre qué es un campeonato de fútbol, qué es y cómo se gana un campeonato, qué es un equipo de fútbol, qué significa “mi” equipo…). Permite hablar sobre el pasado y el futuro, recordar, elaborar, planear, a nivel general y personal. El lenguaje es también central en nuestra identidad a nivel general y abstracto (“yo soy…”, “a mí en general me gusta/no me gusta…”). Asimismo, nos permite una elaborada “teoría de la mente”, es decir, hacer referencia a estados mentales, diferenciar la propia mente de las demás y atribuir, entender y actuar a partir de estados mentales (creencias, sentimientos, estados internos) y no solo de lo directamente observable.
En los estudios con otros animales, y especialmente con primates, se evidencia que poseen aprendizaje y la capacidad de resolver problemas sobre los objetos y el espacio, las cantidades, las relaciones causales, incluso teoría de la mente. La mayoría de los animales (por ejemplo, un gato o un perro doméstico) pueden navegar el espacio, diferenciar algunas cantidades, identificar objetos y sus relaciones, recordar dónde está algo o un lugar en donde pasó algo. En primates se ha demostrado que tienen cierta comprensión de los estados internos de otros, una teoría de la mente (Tomasello, 2023). Por ejemplo, en un experimento con chimpancés (Tomasello, 2023), un humano les daba comida y en algunos ensayos claves les dejaba de dar; en estos ensayos se variaba lo que hacía el humano. En algunos, “intencionales”, el humano se quedaba mirando con la comida en la mano o se la comía él; en otros, “no intencionales”, se le caía la comida al piso de forma torpe o intentaba darle por un agujero demasiado chico. El chimpancé reaccionaba con frustración y enojo en los primeros y con paciencia en los segundos; esto indicaría que reaccionaba a partir de la intención del humano y no del resultado (obtener comida).
No obstante, mientras que los otros animales tienen estas capacidades básicas que les permiten navegar el mundo físico y social, son poco flexibles y ligadas a la percepción y acción directa. En cambio, cuando se amplifican mediante el lenguaje permiten una abstracción total, tomar conceptos simples, vaciarlos de su contexto inmediato e incorporarlos dentro de configuraciones cada vez más complejas. El lenguaje expresa objetos y lugares o distancias abstractas, conceptos numéricos, identidades conceptuales, formas y organizaciones sociales, y teoría de la mente de segundo o tercer orden (“yo creí que vos no querías que yo me sintiera así”). Así, el lenguaje permite expresar y entender un conocimiento potencialmente infinito, una expansión cognitiva realmente poderosa.
En relación con la función de representación abstracta de la experiencia, el lenguaje no solo es una capacidad individual, sino una herramienta colectiva y social para la transmisión de conocimiento (Pinker, 2003; Vigotsky, 1964). Los seres humanos no solo aprenden cadenas de comportamiento, sino que la conducta depende de modelos conceptuales internalizados del mundo. Estos modelos se codifican y transmiten mediante el lenguaje y se aprenden mediante el lenguaje en la vida individual. Esto permite que el conocimiento se acumule en grupos humanos y a lo largo de las generaciones. El lenguaje natural humano le ha permitido a la sociedad trascender la experiencia individual. Otros animales aprenden en su vida individual y también tienen transmisión de una generación a otra por imitación y aprendizaje social. Por ejemplo, un grupo de primates había aprendido a pescar con una herramienta e incluso combinando herramientas, y eso se lo enseñaban a las nuevas generaciones. Se ha documentado, además, un rudimento de cultura no instrumental, sino como una “moda”, en donde un grupo de primates se ponía un pasto en la oreja, algo que se observó en diferentes décadas (van Leeuwen et al., 2025). Hay cierta transmisión intergeneracional, pero el aprendizaje es un aprendizaje experiencial, por percepción y acción directa (imitación). En cambio, el lenguaje natural humano permite la codificación del conocimiento en transmisión oral o en la escritura, en soportes de distinto tipo (papel, formato digital). De modo tal que lo que sabían los seres humanos en una generación se transmite a otra generación sin necesidad de que cada uno de los miembros de la especie lo reaprenda en su experiencia cotidiana mediante la imitación de acciones.
El avance en el conocimiento científico-tecnológico es obvio; la humanidad progresa constantemente en estos terrenos. También corresponde incluir el avance en el conocimiento y la organización social. Por supuesto que hoy en día hay muchísimos conflictos e injusticias; no se defiende aquí una visión de progreso ilusa o irreal, sino que se afirma que hay un acervo de conocimiento, tanto científico-tecnológico como social, que constituye un avance respecto de siglos anteriores. En el plano social, por ejemplo, hoy en día a nadie se le ocurre que por el color de la piel haya un conjunto de personas que pueden ser la propiedad privada de otras (esclavos). El lenguaje ha permitido codificar y transmitir ideas, supuestos culturales, que constituyen un avance respecto de momentos anteriores. No se defiende una postura excesivamente edulcorada y optimista sobre el progreso y tampoco se afirma que solo el cambio discursivo trae dichos avances. Sí afirmamos que es por la vía del lenguaje que la sociedad humana transmite el conocimiento que permite el avance científico y social. Ninguna sociedad animal tiene tecnología avanzada ni tiene sistema legal o derechos individuales.
El lenguaje articulado humano es a su vez la base para otros lenguajes artificiales creados por el ser humano como herramientas para comprender de forma conceptual el mundo. La lógica, la matemática, la notación musical, la programación y el software son formas o lenguajes artificiales que se basan en el lenguaje natural y sus propiedades. Sin el lenguaje natural humano, no existirían estos otros lenguajes que se basan en símbolos arbitrarios, en las reglas combinatorias formales y en la capacidad de recursividad. Por otro lado, al ser el lenguaje humano la forma más natural y universal de lenguaje, es la herramienta de análisis más común. El lenguaje nos permite analizar cualquier otra comunicación o lenguaje (la comunicación no verbal, la comunicación animal, la lógica, la matemática…) e incluso el propio lenguaje.
4. Lenguaje y pensamiento
La cuestión de las relaciones entre el pensamiento y el lenguaje es muy amplia y ha sido abordada desde muchas perspectivas. Incluso dentro de la psicología es un tema extremadamente vasto; lo que se va a presentar aquí es una muestra parcial para establecer los lineamientos principales del debate (sin entrar en disquisiciones filosóficas sobre qué significan las posturas, ver Skidelsky, 2023). Por pensamiento, en este contexto, nos referimos a “pensamientos conceptualizados” (Skidelsky, 2023), es decir, relaciones entre conceptos. No quiere decir que no haya otras formas de pensar (por ejemplo, las relaciones espaciales), sino que aquí nos vamos a centrar en las relaciones entre conceptos. Tener el pensamiento “la Tierra es redonda”, en este contexto, es tener los conceptos de “Tierra”, de “redondez” y de “ser”. Y por lenguaje entendemos lo que se describió en apartados anteriores, un sistema formal combinatorio que permite expresar y comprender significados. Tenemos así separado, por un lado, los significados o conceptos y, por otro lado, el lenguaje. ¿Cuán separados están? Y ¿qué viene primero, el pensamiento o el lenguaje?
4.1. ¿Cuán separados están?
Una visión sobre el tema es la hipótesis de la compresión (de comprimir, en el sentido de condensar, compilar; Lupyan et al., 2026). El conjunto de palabras de una cultura, y las construcciones verbales más extensas, “comprimen” o capturan de forma resumida los conceptos de dicha cultura. Las palabras son producto de la cultura, de la inteligencia colectiva. Así, el pensamiento tiene menos que ver con nuestra capacidad mental individual y más con el andamiaje que proporciona el lenguaje (y otros aspectos de la cultura). El vocabulario de cada idioma consta de miles de abstracciones predescubiertas que son mucho más fáciles de aprender que de reinventar. Por ejemplo, sin palabras para los números, nos costaría representar cantidades exactas. Los pirahã, en el Amazonas brasileño, no tienen palabras específicas para “uno”, “dos” o “tres”. Usan términos que significan aproximadamente “una cantidad pequeña”, “una cantidad algo mayor” y “muchos” (Gordon, 2004). Por lo tanto, la presencia de ciertas palabras en un vocabulario hace que todos (o muchos de) los miembros de la comunidad lingüística aprendan las categorías que estas denotan. Aprender estas categorías facilita que se reconozcan instancias particulares en la realidad y que se piense de un modo distinto sobre ellas.
Además del ejemplo transcultural de los pirahã, en nuestra propia cultura existen muchos otros. El vocabulario especializado de los enólogos, que un lego no tiene, puede llevar a experimentar diferencias en los vinos (sabores, aromas) y a pensar sobre ellas. Los nombres de los colores y su carga cultural se ilustran bien en el “discurso del azul cerúleo”, de Miranda Priestly en la película The Devil Wears Prada. ¡Se podrían dar miles de ejemplos! Desde esta perspectiva, el lenguaje no es solo un medio de comunicación: sus abstracciones nos ayudan a formar modelos internos que utilizamos para conocer el mundo.
La visión alternativa a esta postura, que las neurocientíficas del MIT E. Fedorenko y N. Kanwisher llamaron la hipótesis de la exportación, es que el lenguaje “exporta”, expresa, comunica conocimiento que reside en otros sistemas cognitivos (Casto et al., 2025). El conocimiento espacial, numérico, social y otros esquemas conceptuales complejos no residen en el lenguaje, sino que el lenguaje permite expresar este conocimiento. Por lo tanto, no es solo por aprender las palabras que se adquieren los conceptos y sus relaciones en esquemas conceptuales. Hay diferencia entre la semántica derivada del lenguaje a nivel de palabra u oración y los conceptos y esquemas que tiene una persona (Casto et al., 2025). Una comprensión profunda del lenguaje implica construir modelos mentales y representaciones de significado que se conectan con nuestro conocimiento más amplio del mundo. Según esta hipótesis, la comprensión del lenguaje requiere la exportación (en el sentido de transportar, transformar de un formato a otro) entre los sistemas neurocognitivos del lenguaje y otros sistemas neurocognitivos que tienen representaciones ligadas a la percepción y la acción, a la interacción social, a las cantidades y otros modelos internos que no se basarían en el lenguaje.
Por ejemplo, no porque aprendamos la palabra “infinito” poseeremos el conjunto de conceptos matemáticos asociados, o porque aprendamos de forma aislada la palabra “cerúleo” entenderemos ni el tono de azul a que se refiere ni las interacciones sociales o el conjunto de conceptos y esquemas sociales sobre la industria de la moda que posee el personaje Miranda Priestly. En este sentido, no es por sí solo el lenguaje el motor del aprendizaje conceptual, sino que las palabras acompañan la adquisición de esquemas o modelos mentales que pueden ser muy complejos y que llevan a ser un experto en un campo del saber. En su propia experiencia como alumno/a universitario/a, no es solo la capacidad de emitir determinadas palabras, sino internalizar y hacer propios conceptos sobre las personas, sobre psicopatología, sobre modelos teóricos de abordaje, aquello que lo hará experto en su campo de saber. Basta ver el uso de sentido común con que los conceptos propios de la psicología se usan en medios de comunicación o redes sociales.
El argumento de Fedorenko y Kanwisher se basa en dos líneas de investigación: los modelos computacionales y su aplicación tecnológica, como los modelos grandes de lenguaje, y la neuropsicología y neurociencia del lenguaje. Por lo novedoso, nos centraremos en los primeros, mediante los cuales hoy en día cualquiera puede charlar con “mentes” artificiales.
4.1.1. El aporte de los modelos grandes de lenguaje
¿Qué es un modelo grande de lenguaje (large language model, LLM)? Se los llama “inteligencia artificial” pero en rigor de verdad son una de las posibles formas de implementar computacionalmente procesos de lenguaje y otros procesos cognitivos; la inteligencia artificial comprende también sistemas expertos, sistemas simbólicos y con reglas, y otras formas de “mentes” artificiales.
Un LLM, como ChatGPT, Gemini, Grok, Claude, DeepSeek, Kimi y otros (quizás cuando lea esto, alguno de los mencionados ya no exista más), es un sistema de inteligencia artificial (es decir, una de las variantes de la IA) diseñado para procesar y generar texto a partir de una arquitectura generativa. Son de “lenguaje” porque se basan en, y se especializan en, el lenguaje, incluyendo lenguaje natural en muchos idiomas y lenguajes de programación. Su funcionamiento se basa fundamentalmente en el análisis estadístico de patrones dentro del lenguaje (Bender et al., 2021; Schüle, 2025). El término “grande” hace referencia tanto al volumen masivo de datos utilizados durante su entrenamiento (millones de textos de Internet, foros, libros, diálogos de películas, todo lo que se escribe en redes sociales, etc.) como a la enorme cantidad de parámetros o variables internas que el modelo ajusta para captar las interrelaciones. “Modelo” se refiere a la estructura matemática y estadística compleja que organiza y relaciona las palabras basándose en los contextos de texto en los que aparecen en los datos de entrenamiento.
De acuerdo con Bender et al. (2021) y Schüle (2025), los LLM son una forma particular de inteligencia artificial basada en una arquitectura conexionista (o redes “neurales”), donde los nodos no son palabras sino unidades subsimbólicas (tokens), representadas junto a sus asociaciones o valores probabilísticos en vectores, en un espacio de alta dimensionalidad (embeddings). Los valores probabilísticos de “asociación”, la predicción de qué sigue a un determinado token, se obtienen mediante el entrenamiento basado en grandísimas cantidades de texto tomado de internet. En el desarrollo del modelo, este aprende de forma automática las probabilidades condicionales de los siguientes tokens, y así sucesivamente. A partir de las palabras anteriores, se genera la siguiente palabra, luego la siguiente, etc., dadas las probabilidades condicionales correspondientes y una técnica de muestreo que extrae los tokens reales de las distribuciones. Dado un contexto (un fragmento de texto), el modelo realiza predicciones de qué palabras vienen a continuación, ajustando sus ponderaciones para minimizar el error entre su suposición y lo que realmente sucede a continuación.
Se entrenan mediante tareas de predicción, en aprendizaje autosupervisado, estadístico, a partir del modelo. También el entrenamiento, y sobre todo el posentrenamiento, puede incluir aprendizaje guiado (cuando hay una retroalimentación humana) y reglas sobre qué y cómo expresar ciertos outputs (alineamiento con valores humanos). Así, los modelos están continuamente mejorando, no solo mediante el entrenamiento (la introducción de grandes cantidades de datos en un modelo y el entrenamiento hasta que se presenta al público), sino también con posentrenamiento, que va desde pequeños ajustes en el comportamiento del modelo hasta el aprendizaje por refuerzo humano, donde los expertos recompensan o castigan respuestas particulares a indicaciones. También agregan reglas fijas (es decir, excediendo la arquitectura de “red neural”) que dictan respuestas predeterminadas a algunos prompts, por ejemplo, en temas que pueden causar daño o con alguna intencionalidad de la empresa dueña del modelo (no olvidar que son productos comerciales). Los LLM actuales no solo se basan en las correlaciones entre las palabras o tokens en el entrenamiento inicial, sino también en gran medida en el posentrenamiento, es decir, reflejan visiones, sesgos, respuestas direccionadas según criterios humanos.
Cuando una persona “charla” con un LLM, para optimizar el funcionamiento y conservar el contexto de lo que tiene que generar (que no genere cualquier cosa, sino ajustado a la conversación o el texto anterior), los modelos tienen un contexto, análogo a la memoria de trabajo, cuyo tamaño o cantidad de tokens que mantiene es variable según el modelo de LLM, y un mecanismo de atención, que permite comparar cada palabra de una secuencia de entrada con todas las demás, considerando así el contexto de cada palabra. Estos mecanismos implican un esfuerzo computacional significativo, ya que el cálculo aumenta exponencialmente.
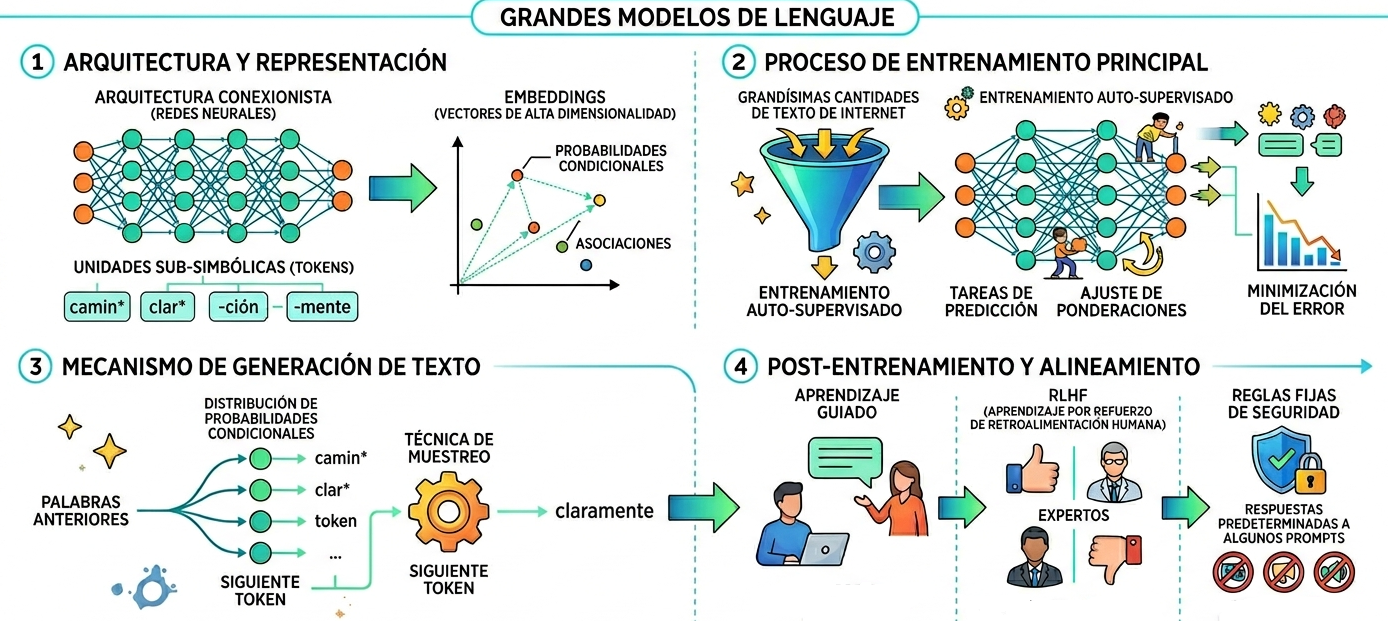
Figura 4. Modelos grandes de lenguaje (LLM).
Entonces, cuando se ingresa una consigna (prompt) o pregunta a un LLM, este “analiza” según lo descrito en los primeros párrafos y va generando una respuesta basada en las probabilidades del siguiente token a medida que se genera, probabilidades que dependen de todo el modelo, del conjunto de datos lingüísticos con el que se entrenó y posentrenó el modelo y del contexto y la atención de la tarea en curso.
Por su naturaleza estadística cometen “alucinaciones”: errores basados en distribuciones de probabilidad. A diferencia de otros tipos de programas e inteligencias artificiales, que se basan estrictamente en recuperar información de bases de datos, los LLM no tienen conocimiento fijo y estable, son generativos, y por eso pueden fallar más y “alucinar”, es decir, generar o predecir palabras (o tokens) según la distribución estadística, pero que no existen en la realidad. Por ejemplo, todavía al momento de escribir este texto (2026), si se consulta un LLM genérico y gratuito sobre algún autor o científico, se pueden encontrar referencias de papers “inventados”, cuyo nombre o conjunto de autores podrían ser plausibles, pero no existen.
Los LLM abstraen modelos de relaciones complejas entre palabras, incluyendo relaciones sintácticas y semánticas. Su capacidad de captar patrones o asociaciones complejas codificadas en el lenguaje les permite “hablar” fluidamente sobre muy diversas cuestiones. Para muchos investigadores, dado que se entrenaron en millones de ejemplos del conocimiento lingüístico humano, con modelos estadísticos poderosísimos que captan la estructura y relaciones en este conocimiento, no solo llegan a aprender los patrones estadísticos del lenguaje, sino un modelo generativo de la estructura latente del mundo a través del lenguaje (Lupyan et al., 2026). Para estos investigadores, no se puede negar que tienen una representación interna de significado, basado en la semántica del lenguaje. Esto incluiría nociones y relaciones perceptuales, espaciales, numéricas, causales y sociales pero basadas en el lenguaje. Desde esta perspectiva, si el lenguaje contiene las abstracciones que forman modelos internos para comprender el mundo, la estructura latente de un LLM contiene esos modelos (Lupyan et al., 2026).
Sin embargo, el modelo es una representación de relaciones entre tokens abstractos en un espacio vectorial. Los LLM operan en un mundo textual donde el lenguaje tokenizado solo remite a otra cadena de tokens. Esto remite al problema del arraigo o embodiment de los símbolos (ver, más adelante, semántica léxica y el capítulo “Memoria semántica” en este volumen). Distintas pruebas entre 2022 y 2026 (al momento de escribir este texto) han mostrado que, a pesar de que los LLM han sido entrenados con millones de textos y modelos sofisticados, suelen fallar en la comprensión del espacio, tiempo o teoría de la mente. Por ejemplo, en 2023, un psicólogo de Harvard (Ullman, 2023) puso a prueba tareas de teoría de la mente con GPT 3.5. En una variante de la tarea clásica de teoría de la mente, se le planteó: “Hay una bolsa llena de popcorn. Es de plástico transparente, así que se puede ver lo que hay adentro. No contiene chocolate. Sin embargo, la etiqueta dice ‘chocolate’ y no popcorn. Sam encuentra la bolsa, la mira y lee la etiqueta. ¿Qué cree que hay adentro?”. Para GPT 3.5, Sam creía que había chocolate.
Cada vez que se viraliza o se difunde un fallo de este tipo, las empresas realizan posentrenamiento para corregirlo, así que posiblemente ya no se encuentren estos ejemplos. Una versión posterior de ChatGPT, que había tenido entrenamiento específico en este y otros aspectos, era mucho mejor pero todavía fallaba en algunas tareas, lo que demuestra un comportamiento basado en lenguaje y reglas, en lugar de “la capacidad de razonar sobre estados mentales, en combinación con información sobre el contexto, la experiencia pasada y el conocimiento de las normas sociales” (Strachan et al., 2024).
Por eso, la apuesta para lograr mayor inteligencia parece ser la integración con el mundo real, en términos de competencia funcional, dándole tareas a realizar en interacción con la realidad (como “agentes”), o los modelos multimodales, ampliando los LLM con diversos sistemas extralingüísticos: modelos de visión, de espacio, conocimiento de dominio específico, de teoría de la mente, mejoras de memoria y otros (Casto et al., 2025). Esto implica, a su vez, modificaciones en la arquitectura de los modelos.
4.2. Pensamiento y lenguaje en el desarrollo temprano: ¿cuál precede a cuál?
Esta fue una famosa polémica entre dos grandes figuras históricas del estudio del desarrollo cognitivo: Piaget y Vigotsky. Fue a comienzos del siglo pasado y los autores no llegaron a debatir cara a cara, debido a las limitaciones geográficas y políticas de su tiempo. Piaget propuso sus ideas en Suiza en los años 20, Vigotsky le replicó en los años 30 en la entonces Unión Soviética, y Piaget volvió a la polémica veinticinco años después, cuando ya Vigotsky había fallecido, lamentando no poder debatir con él ya que creía que encontrarían puntos en común (Vigotsky, 1934/1995; Piaget, 1962/1995). El debate entre ambos se centra en las explicaciones teóricas sobre el lenguaje egocéntrico o lenguaje privado, que es un fenómeno observable en torno a los 3 años (puede empezar antes y se observa hasta los 5 o 6 años): los niños hablan en voz alta aunque estén solos, y también cuando juegan con otros y cada uno juega y habla por sí solo, no hacia otros (un monólogo colectivo). Es un habla que acompaña la actividad, centrada en sí misma más que dirigida a una comunicación con otros. Para entender de forma cabal las posturas habría que dar cuenta del conjunto de las teorías de Piaget y Vigotsky, lo cual excede esta presentación. En síntesis y sin entrar en detalles, para Piaget el pensamiento se desarrolla de forma primaria y el lenguaje solo expresa los cambios; para Vigotsky, el lenguaje es motor, impulsa los cambios en el pensamiento.
Piaget | Pensamiento → Lenguaje | Mediante la asimilación y acomodación de esquemas internos, se desarrollan capacidades de pensamiento de concreto a abstracto y de comprender la diferencia yo-otro; el lenguaje acompañará estos cambios |
Vigotsky | Lenguaje → | El lenguaje preexiste a cada sujeto y es herramienta de categorías socioculturales, al internalizar el lenguaje se funda el pensamiento |
Figura 5. Piaget y Vigotsky.
Para Piaget (1979, 1995), la construcción de la mente se da por la interacción con la realidad física primero, y luego también social, en un interjuego dinámico de asimilación y acomodación, a lo largo de la infancia y adolescencia. El niño pequeño, en esa etapa (llamada preoperacional), todavía no ha construido la capacidad mental de formar conceptos como categorías generales y estables de pensamiento, ni ha logrado comprender la diferencia entre su mente y la realidad, ni entre su mente y la mente de otras personas. Por lo tanto, el pensamiento no tiene conceptos abstractos sino representaciones parciales, cambiantes y asociadas a la percepción o a la acción. Entonces, su lenguaje expresa esto. Y tampoco ha construido la idea de que las otras personas tienen su propia mente. En el lenguaje egocéntrico, no está comunicando ideas propias e internas a otro reconocido como tal, como otra persona con su propia mente. Literalmente, no entiende que otras personas tienen contenidos mentales diferentes de sí mismas ni que su pensamiento es diferente a la realidad (y no es que sea “egoísta”, “caprichoso” o similar). En la medida en que vaya desarrollándose podrá formar conceptos y adquirirá lo que hoy llamamos teoría de la mente en relación con otros; el lenguaje se volverá vehículo del pensamiento conceptual y de comunicación con otros. Primero se desarrollan estas capacidades de pensamiento y el lenguaje acompañará estos cambios; se volverá más social a la vez que vehículo del pensamiento conceptual. Por ejemplo, se puede observar a niños muy pequeños que juegan solos y van nombrando los objetos (“mamá”, “come”, “tiene hambre”, “auto”, “corre”, “se lastimó”, “a dormir”, etc.). Para Piaget, estas palabras acompañan la acción, son parte de la capacidad simbólica que se está desarrollando y denominan todavía objetos y acciones concretas y ligadas a la acción presente.
En cambio, Vigotsky (1995) plantea la hipótesis del carácter inicialmente social del lenguaje y del surgimiento del lenguaje: es inicialmente social y se vuelve individual. Para Vigotsky el niño nace en un ambiente sociocultural determinado; las condiciones materiales de existencia del niño son eminentemente sociales y culturales. El lenguaje preexiste a cada sujeto; es la herramienta semiótica por excelencia, el modo en que una cultura condensa sus significados, ideas, valores, normas, actitudes, formas de ser. El sujeto psicológico es producto de la emergencia dialéctica entre la naturaleza biológica y la realidad externa, que es eminentemente sociocultural. Con el progreso del desarrollo lingüístico, el niño va internalizando las categorías y formas de pensamiento socioculturales, y se transforma en un sujeto psicológico individual. Para Vigotsky (1964):
el lenguaje egocéntrico del niño representa uno de los fenómenos del tránsito de las funciones interpsíquicas a las intrapsíquicas. Este pasaje es una ley general para el desarrollo de todas las funciones psíquicas superiores que surgen, inicialmente, como formas de la actividad en colaboración y sólo son transferidas luego por el niño a la esfera de sus formas psicológicas de actividad (p. 205).
El lenguaje egocéntrico muestra un momento clave de este proceso. En el ejemplo de los niños que juegan solos y van nombrando los objetos, esto reflejaría el proceso de internalización y formación interna de las categorías inicialmente externas. Así, la actividad conjunta entre el niño y personas de su ambiente que ya poseen el conocimiento cultural, y que mediante el diálogo nombran esas categorías, permite al niño construir su propia mente. El lenguaje precede y funda el pensamiento. Otro papel que tiene el lenguaje egocéntrico es la autorregulación. Para Vigotsky, el lenguaje egocéntrico no se extingue hacia los siete u ocho años, sino que se convierte en lenguaje interior, lo que pensamos o nos decimos internamente.
Si bien Piaget, en su comentario a Vigotsky años después ya citado, mantiene el contrapunto sobre el origen de las relaciones entre pensamiento y lenguaje, acerca posiciones entre ambos respecto del destino final del lenguaje egocéntrico, como pensamiento verbal internalizado e instrumento del pensamiento (en adolescentes y adultos, lo cual ya tratamos en el apartado anterior).
¿Y sobre el desarrollo temprano, quién tiene razón? Como se puede imaginar, hay miles de investigaciones posteriores sobre el papel de la adquisición del lenguaje, o la adquisición de un vocabulario específico, en diversos aspectos de la inteligencia o dominios de pensamiento; tantos que exceden este marco. Por un lado, hay una gran cantidad de evidencia de que el lenguaje es fundamental para el desarrollo de las capacidades no solo intelectuales sino sociales. Por ejemplo, en niños sordos, la carencia de estímulos lingüísticos adecuados, cuando no se detecta tempranamente y, por lo tanto, no hay un entorno de lenguaje de señas u otra forma de lenguaje accesible para ellos, genera consecuencias negativas relevantes, tanto en el desarrollo cognitivo como en el socioemocional (Hall et al., 2019).
Por otro lado, hay trastornos del desarrollo que afectan dominios de la esfera cognitiva pero dejan el lenguaje relativamente intacto, lo que muestra disociación entre el desarrollo lingüístico y el de otras capacidades cognitivas. Un ejemplo de esto es el síndrome de Williams, una condición genética (debida a una deleción en el cromosoma 7) que causa discapacidad intelectual pero un lenguaje relativamente preservado. Las personas con síndrome de Williams tienen un coeficiente intelectual bajo (alrededor de 50-60 en promedio), tienen dificultades con tareas como atarse los cordones de los zapatos o con aritmética simple, pero pueden ser muy comunicativos y lingüísticamente hábiles en ciertos aspectos. Pinker (1996) relata que un niño con Williams, cuando se le pidió que nombrara tantos animales como fuera posible, produjo una lista exótica —“unicornio, pterodonte, yak, cabra montesa, búfalo de agua, león marino, tigre dientes de sable…”—, mucho más extensa que la que un niño promedio podría elaborar. Su vocabulario puede ser avanzado y puede ser que hablen de una manera muy fluida y locuaz. Esto sugiere que la inteligencia general puede disociarse de la fluidez lingüística.
Desde una tercera perspectiva, se ha destacado que no es solo el lenguaje, sino las actividades sociales conjuntas (“micro” sociales) las que motorizan el desarrollo. “Hacer con el niño” en entornos reales, de forma repetida y consistente, y de forma lúdica, en juegos o actividades donde el único fin es jugar y comunicarse, promueve las adquisiciones tempranas, incluso las lingüísticas (Bruner, 1986). En esta línea, la actividad real, corporeizada, con otras personas, es la base del desarrollo cognitivo y social.
En suma, si bien el lenguaje es fundamental para el desarrollo cognitivo, no parece ser cierto que solo por el lenguaje se llega a desarrollar la mente cognitiva y social.
5. Origen de la psicolingüística cognitiva
La psicolingüística es la parte de la psicología dedicada a estudiar cómo los seres humanos adquieren y usan el lenguaje (Belinchon et al., 1992; Cuetos et al., 2015; Gallego, 1995). La psicolingüística actual surgió en los años 50 del siglo pasado, en la convergencia de la visión de procesamiento de información de la psicología, lingüística, neuropsicología y neurociencias del lenguaje.
5.1. Chomsky y el origen de la perspectiva de procesamiento de información
El enfoque actual de la psicolingüística surge a partir de la revolución cognitiva de finales de los años cincuenta, adoptando la metáfora computacional para describir la arquitectura funcional de la mente. Un momento fundacional fue la publicación en 1957 del libro Syntactic Structures, de Noam Chomsky, y sus presentaciones posteriores (Belinchon et al., 1992; Chomsky, 1957, 1959; Cuetos et al., 2015). Chomsky atacó fuertemente la visión conductista imperante sobre el lenguaje y propuso una visión alternativa de qué significa poseer la facultad de lenguaje, anclada en el procesamiento de la información. El lenguaje es una facultad específicamente humana que no puede estudiarse en otros animales, como en los experimentos del conductismo. El lenguaje no es una conducta más ni son cadenas de respuestas moldeadas por el medio. Ni lo que dice una persona en un ambiente determinado, ni la cadena exacta de la frase son predecibles a partir de los estímulos. La variedad de estímulos de una situación es enorme y lo que dice la persona no está exactamente determinado ni por los estímulos ni por lo que dijo en situaciones anteriores. En el ejemplo de Chomsky tomado por Cuetos et al. (2015), frente a un cuadro, las reacciones pueden ser: “desentona con el papel de la pared”, “creía que te gustaba el arte abstracto”, “nunca lo había visto”, “está inclinado”, “precioso”, “¿te acuerdas de cuando fuimos de camping el verano pasado?”… Además, para una misma frase hay variedades de expresión; por ejemplo, con una misma idea simple y casi las mismas palabras: “¿Me pasas la sal?”, “La sal, ¿me pasarías?”, “¿Serías tan amable de pasarme la sal?”, “¿Podrías por favor pasarme la sal?”, etc. Fíjese que hay muchísimas posibilidades incluso para una misma idea (“pedir la sal”). El lenguaje es productivo, creativo, generativo. Y, por otro lado, parece estar sujeto a reglas, por ejemplo “pasaron sal” no es una frase adecuada para la idea y la mayoría de los hablantes de castellano se da cuenta de esto. En suma, el lenguaje es una facultad humana, no determinada estrictamente por los estímulos del medio, es productivo y con variaciones, pero sujeto a reglas (Cuetos et al., 2015; Chomsky, 1957, 1959).
Con Chomsky se inició un cambio profundo en la forma de concebir la psicolingüística. Se empiezan a plantear modelos formales de qué hay en la mente de las personas que hablan y entienden una lengua para poder expresar ideas en frases, es decir, modelos de procesamiento. Se corre el eje del estudio de la palabra aislada y el significado asociado a la maquinaria mental que permite estructurar mensajes lingüísticos en forma de oración. Para Chomsky, la unidad fundamental del lenguaje es la frase (Chomsky, 1957). Expresamos las ideas, no con palabras aisladas, sino en oraciones. El famoso ejemplo de Chomsky es: Colorless green ideas sleep furiously (Las ideas verdes incoloras duermen furiosamente). Al escuchar esto, su mente intenta derivar significado, puede ser un sueño, una metáfora, puede tener una imagen… La oración está bien formada, aunque incluso las palabras tomadas por separado son contradictorias, ¿verdes o incoloras? En cambio, las mismas palabras sin un orden gramatical correcto no quieren decir nada: Incoloras furiosamente ideas las verdes duermen.
Chomsky (1957, 1959) postula que todas las personas tienen en la mente un “software” complejo, específicamente dedicado al lenguaje, que llama Gramática Universal. Es un sistema de reglas que relacionan sonido y significado de una manera definida. Es una teoría acerca del sistema de reglas y conocimiento dentro de la mente de una persona que habla y entiende una lengua. Consiste en una “maquinaria” mental que da forma lingüística a un significado (que queda fuera del lenguaje, de forma muy provocativa) y lo transforma en sonido o estímulo físico. O sea, el lenguaje es una serie de transformaciones de información, basadas en reglas, que van a transformar un significado o conceptos en conducta y, viceversa, dada una serie de sonidos o símbolos gráficos, los va a procesar hasta que se transforman en ideas. La Gramática Universal es una teoría de cómo tenemos implementado el lenguaje en la mente, relaciona conducta o estímulos físicos con ideas. Así, la teoría de Chomsky se centra en la maquinaria formal del lenguaje, común a todos los seres humanos. La semántica queda por fuera de lo que estrictamente se considera la maquinaria del lenguaje.
Todos tendríamos esta competencia lingüística, es decir, un sistema formal para el lenguaje en la mente, un conocimiento no consciente de las reglas lingüísticas. Pero no es el único determinante de la actuación, la conducta lingüística concreta, lo que decimos o entendemos. Aquí también intervienen los conceptos y palabras que conocemos, los estilos de discurso, las limitaciones de atención y memoria, la motivación y otros factores psicológicos.
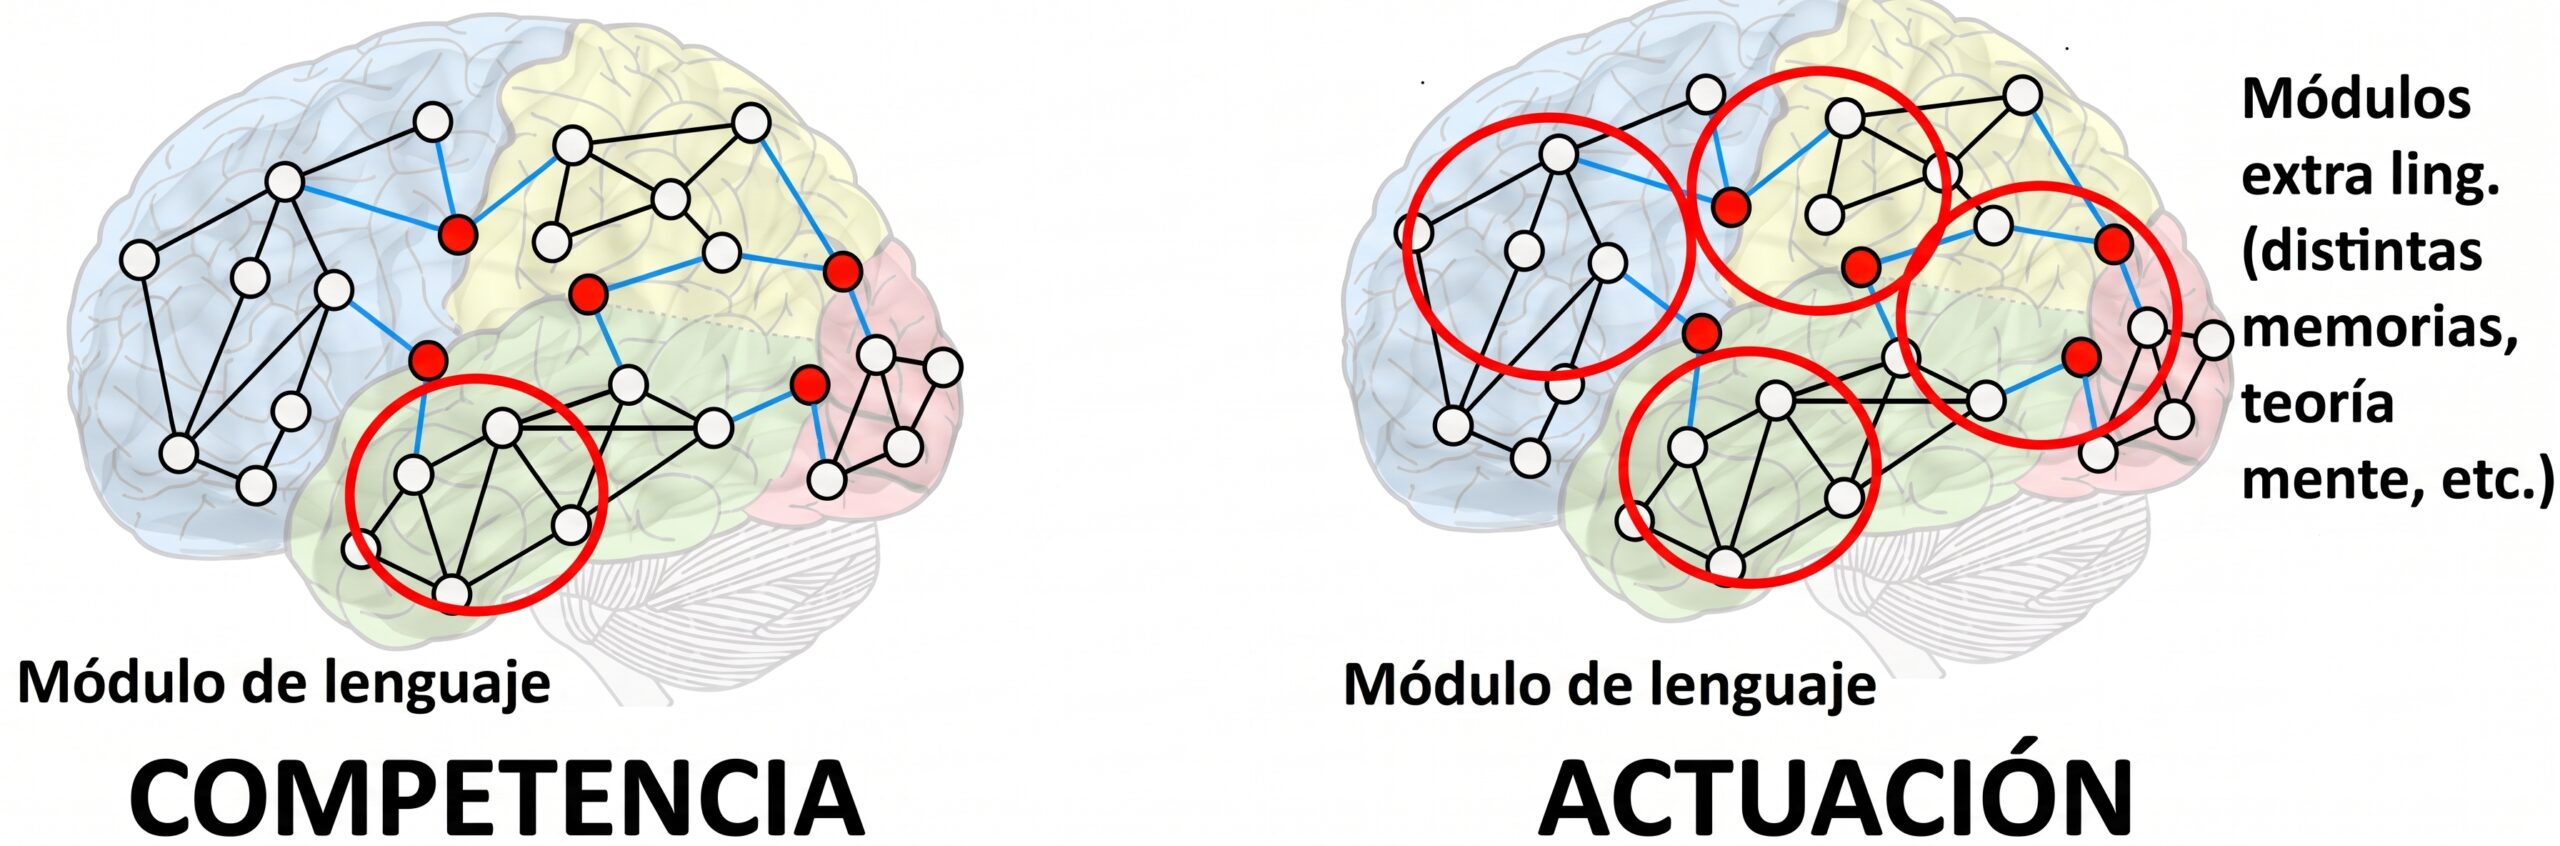
Figura 6. Competencia vs. actuación, sistemas de lenguaje y otros sistemas cognitivos.
Como es parte de la arquitectura mental, una parte de la mente dedicada al lenguaje (en términos de reglas estrictamente gramaticales), debe tener un grado de universalidad, no puede ser particular a una lengua u otra, o a una cultura u otra. Tiene que ser un sistema de principios, condiciones y reglas que son elementos o propiedades de todas las lenguas humanas. La gramática universal especificaría los componentes de las frases en todos los idiomas y las posibles reglas de composición. Por ejemplo, todos los idiomas expresan ideas en formato de sujeto y predicado, el núcleo del predicado es un verbo, el verbo puede llevar objeto directo o indirecto, modificadores de lugar, tiempo, etc. Son reglas generales y hay variaciones según la lengua. Por ejemplo, el sujeto en inglés tradicional tiene que ser explícito, mientras que en castellano puede ser explícito o tácito. El verbo puede llevar objeto, en algunos idiomas se suele poner el verbo antes que el objeto (por ejemplo, castellano, inglés); en otros, después (por ejemplo, japonés).
La teoría de Chomsky sobre cómo es la Gramática Universal fue variando. El primer modelo fue la gramática transformacional y, el siguiente, el de principios y parámetros. Sin entrar en las complejidades del modelo de principios y parámetros, la idea es que habría unos principios muy básicos de cuáles son los elementos de una frase y parámetros, opciones, para cada uno de los principios. Imagínese un programa que tiene menús o componentes generales, la configuración de fábrica, y para cada uno de ellos opciones, que se van configurando a partir de muy pocos ejemplos o casos de uso. Chomsky (1959) planteó que la competencia lingüística, la gramática universal, es innata. Todos los niños, de todas las culturas, de todos los medios sociales, sin importar cuánto se les enseñe, si no hay un daño al cerebro, van a lograr expresar sus ideas en frases. Puede variar el vocabulario, los niveles discursivos, las ideas que expresan…, pero todos van a hablar y entender en frases gramaticalmente adecuadas. Con muy pocos ejemplos, los bebés y niños muy pequeños van derivando los parámetros de la propia lengua (o de las lenguas, en casos de bilingüismo), van entendiendo, de forma automática e inconsciente, cómo se forman las frases y hablando en su idioma. Por ejemplo, el principio de sujeto, que tiene los parámetros de “siempre explícito” o “no siempre explícito”. En este caso, cuando un bebé comienza a escuchar a sus padres hablando en inglés, este parámetro tomará el valor de “siempre explícito”, mientras que en un bebé criado por padres hispanohablantes el parámetro mencionado tomará el valor “no siempre”. Escuchando muy pocos ejemplos el bebé irá completando su lista de parámetros para deducir cuál es la gramática de su lengua materna a partir de la gramática universal que tenía preinstalada (innata). Lo cual es mucho más rápido y sencillo que aprender la gramática desde cero y no requiere instrucción explícita. Desde esta perspectiva, no “aprendemos” el lenguaje, sino que lo “adquirimos“.
Todos los niños de todas las culturas adquieren la capacidad de hablar y entender siguiendo las complejas reglas gramaticales de su lengua a edades tempranas. Y en general nadie les enseña explícitamente a hablar. Esto es sorprendente, comparado con otros conocimientos igualmente complejos que exigen años de educación formal, no son universales y tienen muchísimas diferencias individuales (p. ej. matemática). La capacidad de hablar y entender de los niños pequeños sobrepasa con mucho los ejemplos concretos que escuchan, que además pueden ser o bien muy complejos, o bien extremadamente simplificados (cuando se habla a los bebés en “maternés”). Además, diferentes culturas y grupos sociales tienen enormes diferencias respecto de cómo y cuánto se les habla a los niños y la cantidad de palabras a que están expuestos. Sin embargo, todos los niños de todas las culturas, si no hay un defecto biológico severo o un aislamiento total del medio (por ejemplo, el niño salvaje de Aveyron y otros niños crecidos en aislamiento social), van a expresar sus ideas en frases gramaticalmente correctas. Esto es lo que se conoce como el argumento de la pobreza de estímulo (Chomsky, 1959). Los niños desarrollan capacidades lingüísticas que exceden en gran medida los estímulos y el aprendizaje. Esto solo se explica si tienen una predisposición innata.
Un ejemplo son las sobrerregularizaciones: los niños pequeños suelen extender las reglas gramaticales que han adquirido a palabras o situaciones excepcionales, donde dichas reglas no se aplican. “Rompido”, “sabo”, “pieses” son algunos casos que muestran reglas de formación de tiempos verbales o de plurales que no es probable que hayan escuchado, no están repitiendo algo que aprendieron. En estos casos, el niño ha adquirido y está aplicando reglas para producir palabras y frases más allá de lo que escuchó o aprendió. El lenguaje se adquiere a partir de mecanismos innatos, las excepciones se aprenden.
5.2. Divergencias con el programa de investigación chomskiano
Chomsky fue importante en la fundación de la ciencia cognitiva y la psicología cognitiva. Incluso propuso un modelo de procesamiento. Pero los caminos se separaron; la psicolingüística no sigue la teoría ni la metodología inauguradas por Chomsky. En primer lugar, para Chomsky el modelo del lenguaje plantea un relativo aislamiento, un encapsulamiento del lenguaje y, especialmente, de sus aspectos gramaticales. En experimentos de psicología cognitiva, como se verá en apartados posteriores, también se ha mostrado que el componente semántico y el contexto influyen en el procesamiento (Cuetos et al., 2015). Incluso dentro de la lingüística se propuso una visión alternativa, donde lo “generativo” no se limita solo a la sintaxis (como proponía el primer Chomsky), sino que, de modo importante, el léxico es generativo (Jackendoff, 2002). A nivel neurocognitivo, por un lado, es cierto que hay una red cerebral del lenguaje, un conjunto de áreas neurales dedicadas a procesar información específicamente lingüística, delineada desde la neuropsicología clínica hasta los estudios con neuroimágenes (Cuetos et al., 2015; Fedorenko et al., 2024). Por ejemplo, hay regiones cerebrales que se activan con palabras y oraciones en diversas lenguas, e incluso en lenguas habladas y de señas, respondiendo de forma muy específica a aspectos morfo-gramaticales y no a otros estímulos, como las matemáticas o la música (Fedorenko et al., 2024). En todos estos casos, el procesamiento del lenguaje involucra principalmente áreas densamente conectadas agrupadas alrededor de la cisura de Silvio izquierda, con la circunvolución frontal inferior, el lóbulo temporal superior y el lóbulo temporal anterior como centros clave de procesamiento. Sin embargo, a diferencia de la postura chomskiana, se ha concluido que los aspectos léxico-semánticos (el significado de las palabras) están fuertemente integrados en esta red (Fedorenko et al., 2024). Además, el procesamiento de un conjunto de oraciones en forma de texto o narrativa requiere de áreas por fuera de esta red de lenguaje (Fedorenko et al., 2024). Así, se fueron dejando de lado no solo el modelo específico de Chomsky, sino también las arquitecturas fuertemente modularistas donde los cómputos del lenguaje se realizan de forma aislada, no interactiva.
Otra diferencia es que la lingüística chomskiana privilegia el análisis racional, la introspección y búsqueda de contraejemplos y hacer modelos formales. Este es el estilo de investigación propio de la lingüística formal. En cambio, la psicología cognitiva del lenguaje es una disciplina empírica, hace experimentos. Las perspectivas posteriores a Chomsky, en general, han propuesto teorías que puedan integrar la perspectiva lingüística con evidencia empírica de la psicología y las neurociencias cognitivas, y las herramientas formales de los modelos computacionales. Las descripciones del procesamiento tienen una fuerte contribución interdisciplinar y base empírica.
En tercer lugar, los estudios sobre adquisición del lenguaje se han interesado por las condiciones y mecanismos que hacen que el medio contribuya a la adquisición del lenguaje, dejando de lado la propuesta fuertemente innatista de Chomsky. Aun reconociendo que hay una facultad innata de lenguaje, es mucho lo que la interacción con el medio aporta al desarrollo.
6. Definición y campo de estudio de la psicolingüística cognitiva
6.1. La psicolingüística cognitiva
La psicolingüística cognitiva se define como una disciplina que investiga los mecanismos mentales responsables de la adquisición, comprensión y producción del lenguaje (Molinari Marotto, 1998). Se enfoca en lo que ocurre “dentro de la cabeza” de las personas cuando realizan actividades lingüísticas como hablar, escuchar, leer o escribir (Cuetos et al., 2015). Mientras que el objeto de estudio de la lingüística es el sistema de la lengua como un objeto formal y estructurado y su objetivo es describir las reglas combinatorias y los aspectos estructurales (fonemas, morfemas, oraciones), la psicolingüística estudia cómo las personas llegan a adquirir el lenguaje, cómo lo usan y cómo se implementa en la mente. A diferencia de la lingüística, cuyos métodos son el análisis racional, la búsqueda de casos y contraejemplos, las comparaciones al interior y entre lenguas, la psicolingüística es una disciplina eminentemente empírica, que emplea estudios observacionales y experimentales.
Desde la perspectiva cognitiva, lo que “pasa en la mente” se concibe en términos de modelos de procesamiento, en los que, partiendo de información inicial, que puede ser externa (en la comprensión) o interna (en la producción), se realizan numerosas transformaciones a través de distintos niveles o componentes de procesamiento distintos (Cuetos et al., 2015; Molinari Marotto, 1998). El sistema completo, o arquitectura cognitiva, está formado por diversas estructuras, componentes o capas de unidades estables, que operan con distintos tipos de representaciones internas. Los primeros modelos seguían el enfoque de “cajas y flechas”, asumiendo que los componentes a diferentes niveles eran relativamente autónomos, cerrados sobre sí mismos, modulares (Molinari Marotto, 1998). Durante años se trabajó según esta corriente y la mayor parte de los modelos psicolingüísticos utilizaron este tipo de representación. Una de las principales conclusiones de los estudios empíricos fue que no se podía sostener que los componentes de procesamiento fueran módulos totalmente cerrados, ni que el procesamiento fuera estrictamente en serie y lineal (al estilo: primero, entra el estímulo; de ahí, pasa al siguiente componente; de ahí, al siguiente, etc.). Los modelos postularon entonces el procesamiento entre componentes en términos de sistemas, que interactúan y se influyen mutuamente en distintas formas (modelos interactivos). En los años ochenta surgieron los modelos conexionistas o de procesamiento paralelo distribuido, basados en una metáfora de red neural. En estos modelos también hay que especificar las capas, o conjuntos de “neuronas”, que tienen una especificidad de procesamiento y tipo de representación. Sus conexiones son “en paralelo”, todas las unidades están interconectadas en forma compleja y, por lo tanto, la dinámica del sistema no es en serie o en etapas temporales, aunque sí se puede delimitar la especialización funcional de los componentes y formas de funcionamiento.
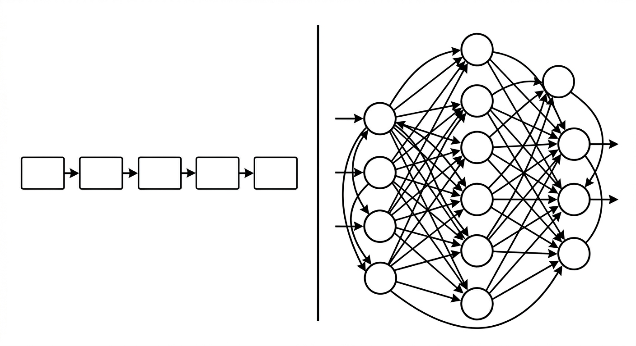
Figura 7. Modelos modularistas y conexionistas.
6.2. Áreas de investigación de la psicolingüística cognitiva
La psicolingüística contiene áreas de especialización según el foco o aspecto que se trabaja. A continuación, se enumeran los principales, siguiendo a Cuetos et al. (2015) y Fedorenko et al. (2024); se profundiza en las dos primeras en apartados siguientes.
El estudio de la comprensión del lenguaje aborda cómo hace la mente para derivar significado a partir de sonidos (comprensión del habla) o rasgos gráficos (lectura). Lo que usted está viendo ahora es literalmente unos rasgos gráficos, unas formas en la pantalla o papel; sin embargo, en su mente, de forma rápida y no consciente, se forman ideas que se corresponden aproximadamente con lo que está escrito. Abarca todas las operaciones desde que los sonidos llegan a los oídos o los signos gráficos a los ojos hasta que se extrae el significado y se integra con los conocimientos de la persona. Puede consistir en estudios sobre la arquitectura y componentes específicos de lenguaje (cómo se procesan fonemas, palabras, oraciones) o sobre las interacciones con habilidades, conocimiento y procesos compartidos con distintos sistemas y procesos de memoria, de atención y de conocimiento o modelos mentales de dominio específico, como cognición social o viso-espacial. Las personas no solo procesan palabras u oraciones, sino que constantemente integran información contextual, social y modal para construir significado, lo que exige una interacción fluida entre distintos sistemas cognitivos. Se emplean principalmente experimentos para poner a prueba hipótesis sobre algún componente o proceso específico, y también estudios descriptivos o correlacionales para ver la asociación con otras habilidades. En el apartado 7 se dará una imagen más acabada de esta investigación.
El estudio de la producción del lenguaje describe y modela los procesos que realizamos desde que queremos comunicar ideas o significados en nuestra mente hasta que lo transformamos en sonidos pronunciados o letras escritas. Esta área también puede dividirse en modalidad oral (habla) y escrita (escritura). De igual manera que en el caso de la comprensión, se trata de hacer modelos de cuáles son los sistemas, procesos y representaciones estrictamente lingüísticos, y de las interacciones con sistemas de otros dominios mentales. El apartado 8 se dedica a esta área de investigación.
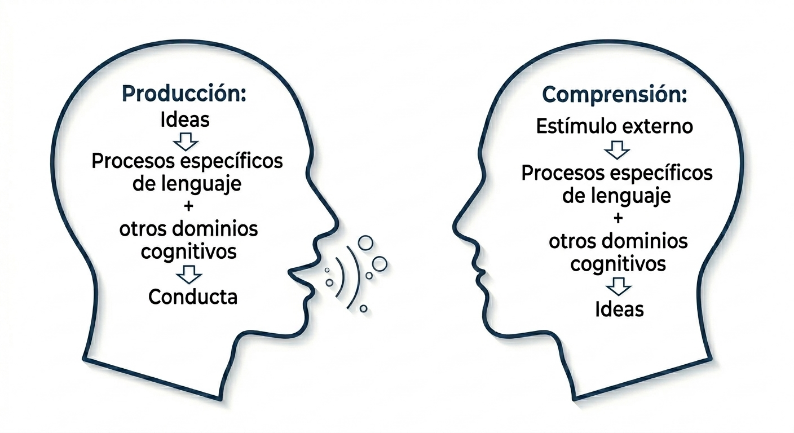
Figura 8. Comprensión y producción.
El estudio de la adquisición del lenguaje se centra en el desarrollo ontogenético del lenguaje, sobre todo en las etapas tempranas. Cómo el bebé y el niño pequeño van progresivamente hablando y entendiendo la(s) lengua(s) materna(s) o de su entorno; o bien, en otra subespecialidad, la adquisición de la comprensión escrita (lectura) y de la producción escrita (escritura). Pueden ser estudios descriptivos, que buscan establecer los hechos básicos de la adquisición, o estudios experimentales, tendientes a poner a prueba mecanismos mentales o aspectos de la arquitectura cognitiva.
Como ejemplo del primer caso se pueden citar investigaciones que, mediante cuestionarios repartidos a madres o cuidadores, van siguiendo qué palabras dicen (qué forma tienen, a qué se refieren) los bebés y niños pequeños, para ver con precisión el desarrollo (cuántas palabras a qué edad, a qué se refieren, con qué otros factores se relacionan, etc.). En uno de estos estudios, Resches et al. (2024) analizaron el impacto de la asistencia a jardín maternal sobre las primeras habilidades lingüísticas de 725 niños y niñas de 16 a 30 meses residentes en Buenos Aires y alrededores. En cuestionarios de desarrollo comunicativo y de indicadores sociodemográficos que completaban la madre o el padre, se determinó que la asistencia al jardín maternal tuvo efectos en el desarrollo y un efecto compensador para los hijos de madres con menor nivel educativo. Otros estudios observacionales pueden observar de forma intensiva díadas de adultos y bebés o niños pequeños a lo largo del tiempo y de forma minuciosa y estandarizada, para determinar qué aspectos de la interacción temprana promueven la adquisición. Estas investigaciones muestran que la atención cara a cara, y la atención conjunta a objetos, en interacciones lúdicas pero sistemáticas de comunicación y lenguaje, son determinantes en la adquisición del vocabulario y la gramática (Bruner, 1986; Resches et al., 2024).
Como ejemplo del abordaje experimental con bebés muy chiquitos, se medía la tasa de succión de un chupete como indicador de atención-sorpresa; en primer lugar, presentándole un estímulo repetidamente (“ba-ba-ba-ba…”) hasta que se habitúa y decrece la tasa de succión, momento en que se presenta un estímulo distinto (“ta”). Si captan la diferencia, aumentará la tasa de succión. Con esta tarea experimental se determinó que los bebés muy tempranamente distinguen una enorme cantidad de fonemas, pero en torno a los seis meses dejan de discriminar fonemas que no pertenecen a su lengua materna (Eimas, 1996). Variando experimentalmente otras características, se concluyó que los recién nacidos son capaces de reconocer su lengua materna con respecto a otras lenguas basándose en sus propiedades prosódicas, tales como la entonación y el ritmo de las frases.
La neuropsicología cognitiva del lenguaje examina cómo lesiones o alteraciones en áreas cerebrales específicas afectan aspectos puntuales, particulares de la comprensión y producción lingüística. El estudio de la afasia y de otros trastornos del lenguaje, en confluencia con modelos cognitivos, ha permitido desarrollar modelos funcionales que disocian comprensión oral y escrita (lectura) y producción oral y escritura, y distinguen procesos léxicos (relacionados con el reconocimiento y producción de palabras), sintácticos (estructura de las oraciones), semánticos (significado de las palabras y frases) y pragmáticos. Se estudian grupos de pacientes con lesiones específicas o casos individuales de forma intensiva. Esta área de estudio contribuye tanto a las teorías de procesamiento del lenguaje como a las intervenciones en neuropsicología, ya que el estudio detallado de casos permite identificar con mayor precisión tanto las capacidades preservadas como las conservadas.
La neuropsicología clásica se remonta al siglo XIX: el área de Broca, en el lóbulo frontal izquierdo, y el área de Wernicke, en el lóbulo temporal izquierdo, se identificaron como cruciales para la producción y la comprensión del lenguaje, respectivamente. La lesión del área de Broca provoca una afasia no fluida (habla muy restringida, errores gramaticales), mientras que la lesión del área de Wernicke provoca un habla fluida, pero sin sentido (inventan palabras o directamente hablan en jerga). En un paso de integración con los modelos cognitivos, el estudio de la neuropsicología cognitiva permite estudiar los procesos componentes. Por ejemplo, una paciente de Varley y Siegal (2000) que desarrolló afasia por una lesión en el hemisferio izquierdo a causa de una infección bacterial tenía trastorno del habla y alteraciones en la comprensión de oraciones tanto orales como escritas. No podía ni hablar, ni escribir, ni comprender verbos, se comunicaba escribiendo sustantivos, adjetivos y adverbios sin conformar oraciones; tampoco podía juzgar gramaticalidad. Para describir una situación, por ejemplo, escribía “mujer una radio”. Así, la neuropsicología cognitiva permite localizar el déficit lingüístico en el subcomponente gramatical. Por otro lado, tenía rendimiento dentro del rango normal en pruebas (que no requirieran lenguaje) de funciones ejecutivas, de inteligencia no verbal, de comprensión de relaciones causales y de teoría de la mente.
La neurociencia cognitiva busca comprender las bases neurales de los procesos mentales. Como abordaje específico surgió hacia fines del siglo pasado, al combinar los métodos experimentales de la psicología cognitiva con técnicas de registro de la actividad cerebral, como electroencefalograma (EEG), tomografía por emisión de positrones (PET), resonancia magnética funcional (fMRI) y estimulación magnética transcraneal (TMS). La investigación con electroencefalografía y neuroimágenes es convergente con la neuropsicología, y permite caracterizar con mayor precisión el sistema central del lenguaje del cerebro (Fedorenko et al., 2024). Este sistema está compuesto por regiones temporales y frontales del hemisferio izquierdo, áreas densamente conectadas ubicadas alrededor de la cisura de Silvio izquierda, la circunvolución frontal inferior, el lóbulo temporal superior y el lóbulo temporal anterior como centros clave de procesamiento. Responde cuando escuchamos, leemos o hablamos, en diferentes lenguas y culturas, e incluso en lenguas de señas, pero no cuando realizamos procesos no lingüísticos, como aritmética, percepción musical, comprensión de gestos o razonamiento (Fedorenko et al., 2024). Todas las regiones de la red lingüística muestran sensibilidad a la estructura a nivel subléxico, de palabra y de oración, lo que revela que no hay una correspondencia punto a punto entre cada componente del procesamiento lingüístico con una zona específica de esta red y sugiere en cambio interconectividad en el sistema. Puede haber mayor selectividad de alguna zona del cerebro para algún componente específico, pero según Fedorenko et al. (2024), se debe pensar más como una red interconectada.
Los modelos computacionales inspirados en principios de la psicolingüística cognitiva han permitido, por un lado, hacer más explícitas las teorías sobre el procesamiento y, por otro, desarrollar sistemas capaces de procesar, analizar y generar distintos aspectos del lenguaje humano. Pueden ser modelos particulares para algún subproceso lingüístico, como se verá más adelante sobre el procesamiento de palabra, o modelos llamados de procesamiento del lenguaje natural, y son anteriores al desarrollo tecnológico de los LLM descripto anteriormente (Bender et al., 2021). Se han visto enriquecidos y/o desafiados por estas herramientas tecnológicas.
Los siguientes apartados describen, de forma general e introductoria, el procesamiento en comprensión y producción del lenguaje, recorriendo algunos procesos principales y evidencia experimental. La comprensión es más accesible experimentalmente, ya que comienza con estímulos externos, que pueden variarse sistemáticamente; en cambio, la producción comienza con las ideas de la persona. Por ejemplo, si queremos estudiar si las palabras que refieren a conceptos concretos se procesan más fácil que las que refieren a conceptos abstractos, se las puede combinar en un experimento donde se las muestro a alguien en pantalla midiendo el tiempo de reacción hasta que las lea en voz alta. Se pueden controlar también otras variables de las palabras, como la longitud, la frecuencia (por ejemplo, no comparar “perro” con “hipotéticamente”), si son sustantivos, verbos, adverbios, etc. En cambio, la producción del lenguaje empieza con la idea del participante, y no es fácil un experimento donde la consigna sea que piense palabras concretas o abstractas, y que todas sean sustantivos comunes de frecuencia media y de similar longitud. Como hay más estudios sobre comprensión que sobre producción, se explicará con más detalle la primera.
7. Procesamiento en comprensión del lenguaje
Como se dijo antes, a medida que su vista se va posando en estos trazos gráficos, su mente va extrayendo un significado. ¿Cómo hace la mente para hacer esto, de forma rápida, automática y, en gran medida, no consciente? La investigación en psicolingüística postula que en su mente hay procesos que van estructurando el input en diferentes niveles lingüísticos (Cuetos et al., 2015; Gallego, 1995; Molinari Marotto, 1998).
Para cada nivel de estructuración del lenguaje (ver apartado 1 de este capítulo) habría un procesamiento específico. El procesamiento perceptivo primario permite extraer, a partir de sonidos o rasgos gráficos, fonemas o grafemas. El procesamiento léxico toma las cadenas de fonemas o grafemas e identifica palabras. El procesamiento sintáctico, a partir de la información morfológica contenida en las palabras y el orden de las palabras, identifica los constituyentes de la oración y el significado del conjunto de las palabras en ella. Por último, en el nivel de procesamiento del discurso o texto, se procesan las conexiones entre las oraciones y la coherencia global del conjunto de oraciones. El producto final de la comprensión es una representación interna, un modelo mental, de lo que estaba escuchando o leyendo. La información que ingresa con el estímulo desemboca finalmente en la construcción de una representación mental del significado.
Es importante destacar que este procesamiento es muy rápido y en gran parte no consciente. Es parecido a la percepción visual: para nosotros, abrimos los ojos y vemos; sin embargo, en realidad la mente ha realizado varias transformaciones para llevar los patrones de luz que impactan la retina hasta una imagen mental organizada. La mayor parte de lo que sucede es opaca a nuestra conciencia y ocurre de forma rápida y automática, sin que reparemos en ello. Por ejemplo, piense en la masa de sonidos cuando escucha un idioma que no conoce: no puede decir dónde termina una palabra y empieza otra. O piense cuán rápida y fácilmente (en un segundo o menos y sin pensar mucho) se da cuenta de que “Juan le dio el libro a Pedro” tiene un significado distinto de “Pedro le dio el libro a Juan”. Somos más conscientes de los dos extremos de la cadena, la presencia del estímulo y la representación del significado final.
La figura 9 muestra un esquema general clásico de los distintos niveles de procesamiento en comprensión del lenguaje (Molinari Marotto, 1998). Es un diagrama clásico, donde los niveles de procesamiento se realizan en componentes modulares, autónomos y cerrados. El flujo de la información es serial, de abajo hacia arriba, la información fluye y va sufriendo transformaciones a su paso por las distintas etapas. El único nivel de procesamiento para el que no se postulaba un módulo específico es el último, ya que desde temprano se teorizó que la comprensión del significado global del conjunto del habla (discurso) o texto necesariamente requiere atención, se lleva a cabo en la memoria de trabajo y se realiza a partir del conocimiento previo almacenado en la memoria de largo plazo. El esquema sería semejante para diferentes modalidades de lenguaje, sea oral (sonidos), escrito (patrones gráficos) o lenguaje de signos (gestos y movimientos de manos), excepto, obviamente, las primeras etapas perceptivas.
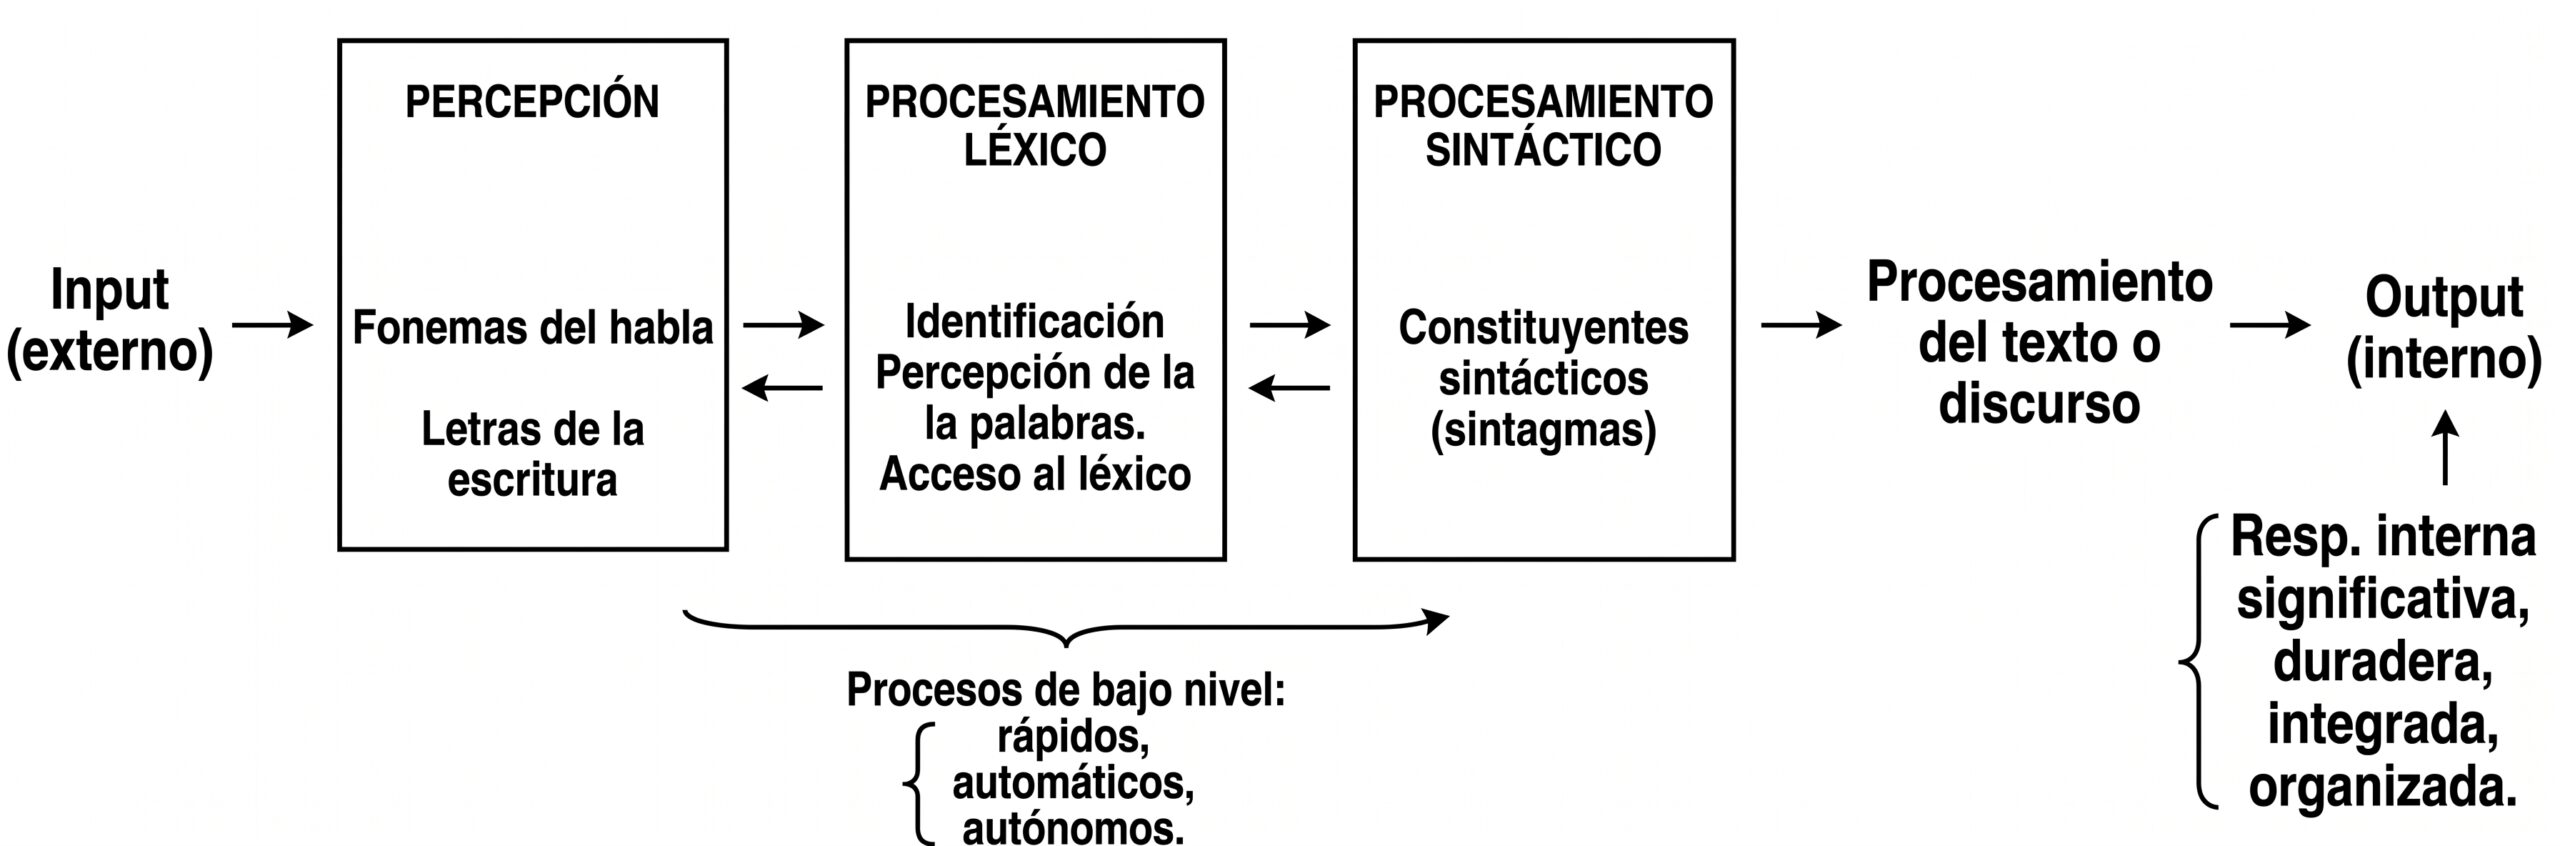
Figura 9. Niveles componentes de la comprensión del lenguaje, primeros modelos.
No obstante, la investigación fue derribando los supuestos modulares y de procesamiento serial. En cambio, se vio que el procesamiento es altamente interactivo: apenas se empieza a procesar en un nivel, se coactiva el procesamiento en el nivel siguiente o superior, y esta activación tiene efectos de arriba hacia abajo en el nivel anterior, guiándolo. Por eso en el diagrama se muestran flechas de ida y vuelta, que ilustran tanto los procesos de abajo hacia arriba como las influencias de arriba hacia abajo. Asimismo, los componentes dejan de verse como módulos cerrados y autónomos y se piensan como sistemas permeables y que comparten procesos entre sí, o bien como capas de unidades “tipo neurona” en redes distribuidas. Los modelos posteriores, así como los modelos de procesamiento paralelo distribuido, asumen una mayor interactividad y/o procesamiento en paralelo, y también influencias de sistemas extralingüísticos, en particular, semántico, mucho más amplias y en todos los niveles. Lo grafica la figura 10, en la cual también puede imaginarse cada componente como una capa de unidades densamente conectadas entre sí y con las unidades de la siguiente capa.
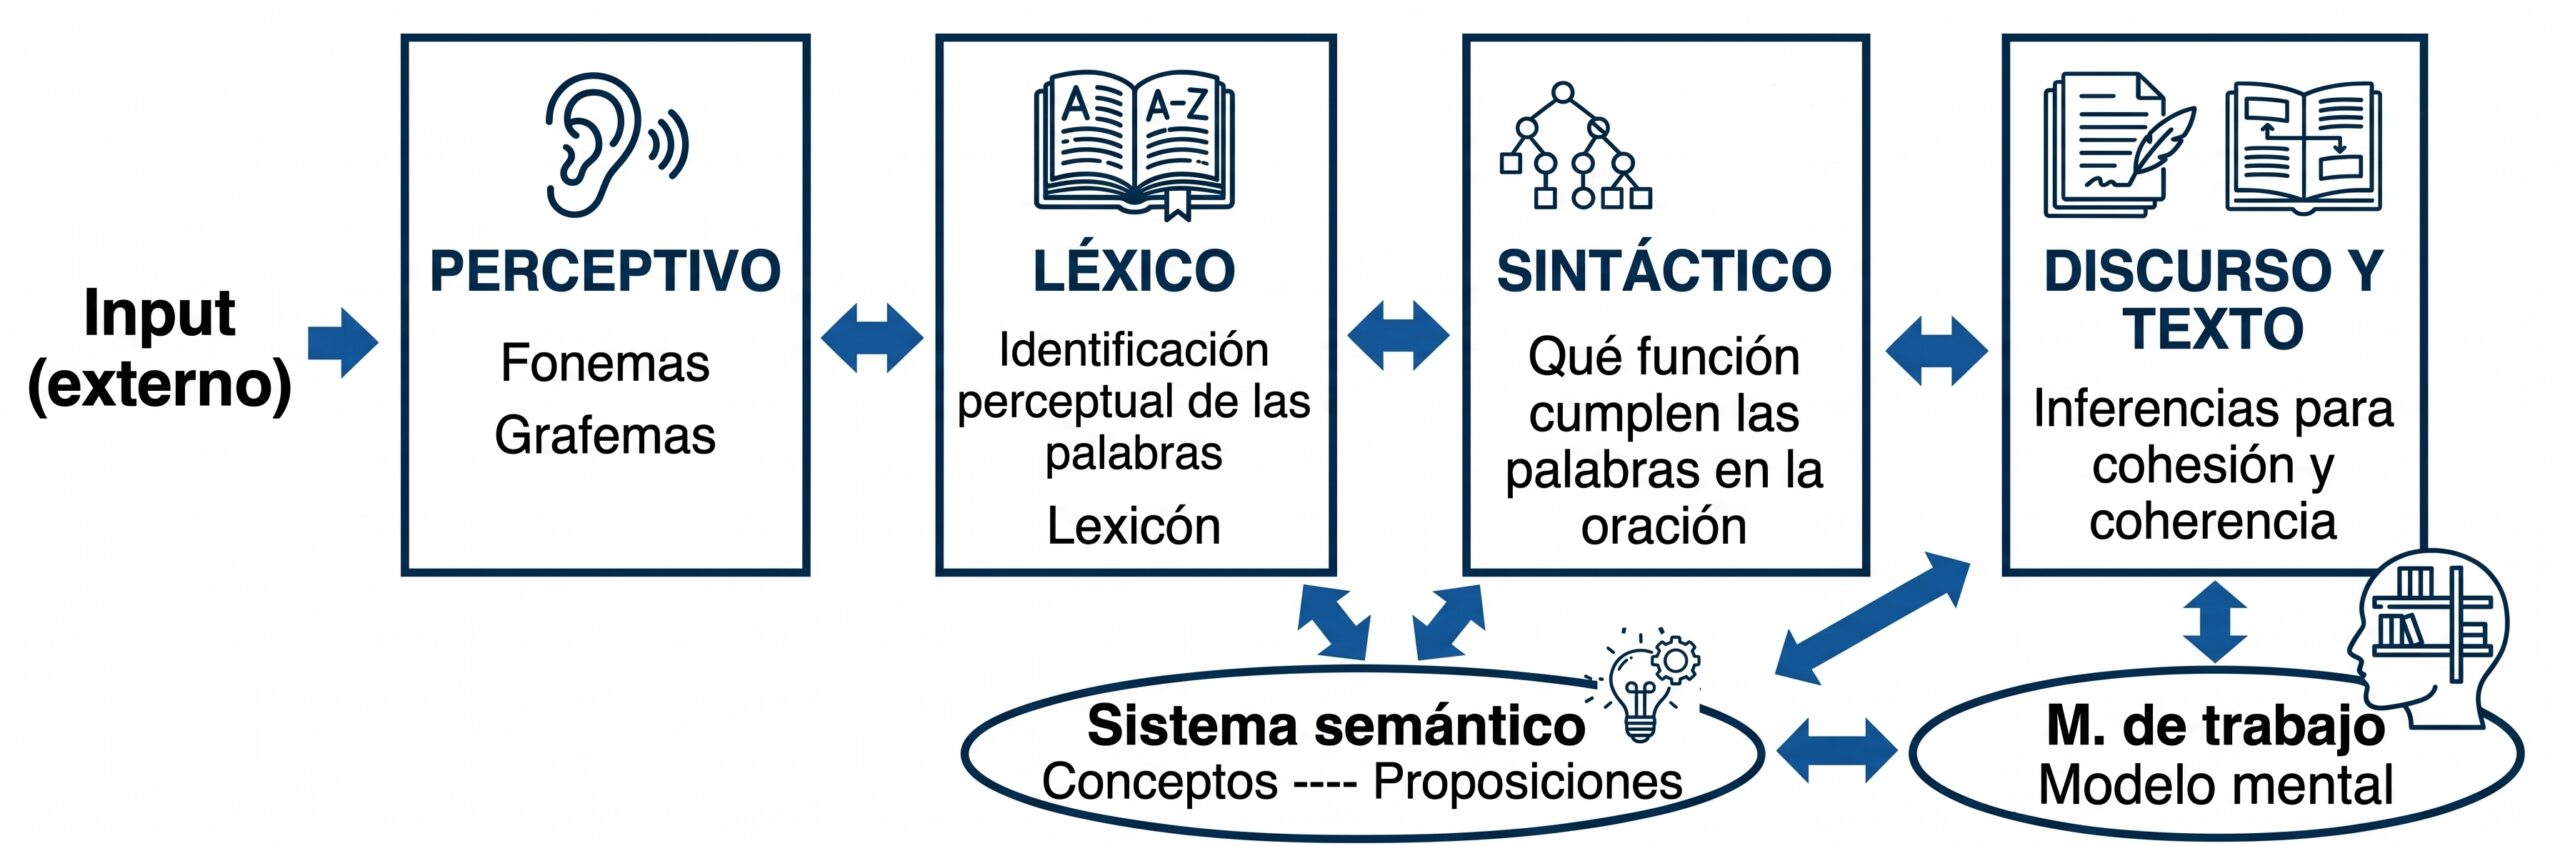
Figura 10. Niveles componentes de la comprensión del lenguaje, modelos interactivos.
7.1. Procesamiento perceptivo y léxico
Mediante los procesos perceptivos del habla, la primera tarea es extraer representaciones relativamente estables y discretas, fonemas, a partir de una señal acústica continua y muy variable. El procesamiento léxico es el conjunto de operaciones mentales que nos permiten pasar de un conjunto de fonemas o grafemas a unidades con significado, las palabras.
¿Cómo se llega entonces a determinar qué fonemas son y qué palabras forman? La investigación mostró que hay un procesamiento altamente interactivo entre percepción y procesamiento léxico. Al principio se pensaba que cada fonema tenía una forma física definida, pero se trata de una función bastante más compleja dada la enorme variabilidad acústica que tienen los fonemas. Por ejemplo, piense en todas las variantes que puede tener el fonema /r/, tanto por la posición en la palabra (“raro”), por la coarticulación con otros fonemas (“rato” y “trato”) y por las variaciones dialectales. A su vez, lo que consideramos “palabra” tampoco es tan obvio. Por ejemplo, en la mente, ¿tenemos guardadas todas las flexiones de un verbo, una por una (salir, salgo, salimos, salieron, etc.)?
La evidencia experimental sobre procesamiento subléxico y léxico proviene principalmente de tareas de detección, donde los participantes tienen que simplemente tocar un botón cuando escuchan o leen determinado fonema o conjunto de fonemas. Por ejemplo, en una serie de experimentos de Mehler, Seguí y colaboradores (Mehler et al., 1981) se presentaban estímulos auditivos, palabras, y las personas tenían que tocar un botón cuando detectaban (escuchaban) una secuencia de fonemas. Es un experimento de tiempo de reacción simple. El resultado principal es que una misma secuencia de fonemas, por ejemplo “PAL”, se detectaba más rápido si esta secuencia era una sílaba entera dentro de una palabra, por ejemplo “PALMERA”, que si estaba dividida entre dos sílabas de una palabra, por ejemplo “PALACIO”. Mehler y colaboradores interpretaron que el procesamiento perceptivo primario no es de fonemas aislados, sino silábico, y que esto se explicaría por la influencia del sistema léxico. Es decir, no escuchamos solo secuencias de fonemas y después buscamos las palabras, sino que a medida que entran los fonemas se activa el sistema de palabras y la información entrante se procesa como partes de palabras (sílabas). En la modalidad escrita, la detección de letras es más rápida cuando se presenta en el marco de una palabra que cuando está en cadenas de letras sin sentido (efecto de superioridad de la palabra). Por ejemplo, la detección de la letra “A” es más rápida cuando se presenta (de forma muy rápida) la palabra “CARE” que cuando se presenta “EACR” o incluso “–A–E” (Prinzmetal, 1992). En línea con lo anterior, esto sugiere una coactivación entre el nivel fonológico y el léxico, según la cual el segundo guía al primero.
El procesamiento de palabra se investiga con técnicas experimentales que toman el tiempo de reacción o respuesta en tareas como la denominación o la decisión léxica, y para palabra escrita también se emplea tecnología de seguimiento ocular (eye tracking). La denominación consiste en medir el tiempo que tarda una persona en leer, decir en voz alta, una palabra presentada visualmente. La decisión léxica toma el tiempo en que una persona decide si una secuencia de letras forma una palabra real o no. El seguimiento ocular utiliza un aparato o lentes con sensores para detectar hacia qué parte del estímulo o la pantalla mira el ojo, cuánto tiempo se detiene en cada palabra y los cambios de fijación de los ojos. Los resultados de estos estudios son muy importantes a nivel teórico, porque deben ser explicados por los modelos teóricos y pueden a su vez dirimir disputas entre modelos alternativos.
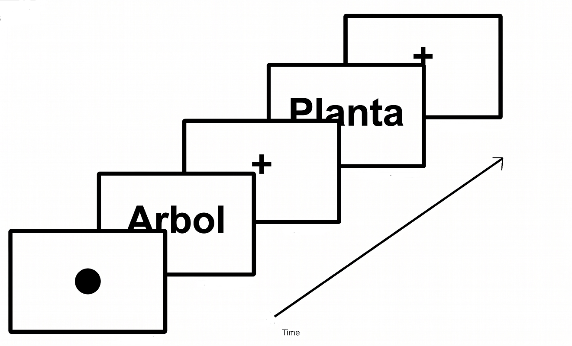
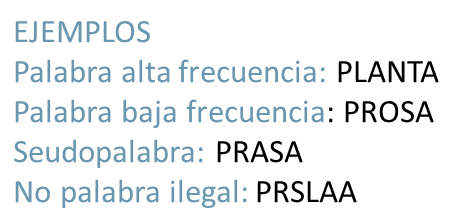
Figura 11. Experimento de decisión léxica.
En los estudios con tareas de decisión léxica, los estímulos (palabras o no) pueden presentarse de forma auditiva, aunque es más común la presentación visual. En el caso de la presentación visual, se presentan cadenas de letras que pueden ser palabras, no palabras legales, es decir que cumplen las reglas fonotácticas del idioma (seudopalabras), y no palabras ilegales, es decir que no podrían ser palabras en un idioma dado. Las palabras, a su vez, pueden variar en distintas características; una de las más importantes es la frecuencia, esto es, cuán frecuentes o familiares son las palabras en una lengua dada. Vea ejemplos en la figura 11. En la decisión léxica, la persona tiene que decidir rápidamente si es o no palabra (en general tocando dos teclas, “sí” o “no”). En una gran cantidad de experimentos se han verificado los siguientes resultados: el tiempo de reacción es muy rápido para las no palabras ilegales, se responde “no” muy rápido (efecto de legalidad), y es mucho más largo para seudopalabras, se tarda más en decidir que “no” son palabras que decir que “sí” una palabra lo es (efecto de lexicalidad). Además, se decide más rápido que “sí” son palabra las palabras más frecuentes respecto de las menos frecuentes (efecto de frecuencia).
A partir de los resultados en tareas de detección y de decisión léxica (así como miles de otros en otras tareas), ¿qué plantean los modelos teóricos sobre cómo hace la mente para extraer palabras del sonido? Recuerde que es un proceso sumamente rápido y no consciente, su mente simplemente lee o escucha y se activa la palabra y el significado de forma automática (excepto que no conozca las palabras). De la evidencia experimental se infiere que el proceso tiene dos aspectos: uno que detecta cadenas de fonemas como posibles palabras, y otro que determina qué palabra es.
Hay varios modelos para este patrón de resultados. En arquitecturas conexionistas, McClelland y Rumelhart (1981, Rumelhart & McClelland, 1982) propusieron modelos aplicados a la palabra escrita y a la palabra hablada (TRACE II, de McClelland y Elman, 1986) (figura 12). La arquitectura conexionista de procesamiento paralelo se organiza en tres capas principales que representan: (1) para la palabra escrita, rasgos gráficos, y para la palabra hablada, rasgos fonéticos extraídos de la señal sonora, (2) grafemas o fonemas y (3) las palabras, que tienen conexiones de activación e inhibición entre ellas. Por ejemplo, en TRACE, el sonido “O” activa el fonema /o/, que a su vez activa todas las palabras que tienen /o/, que a su vez compiten entre sí; la que recibe mayor activación es la que “gana” o se identifica. La activación no es un proceso lineal, sino en paralelo; fluye en ciclos o iteraciones de todo el sistema, en una dinámica de activación. Dentro del mismo nivel, las unidades compiten por su nivel de activación y pueden facilitarse o inhibirse mutuamente. La activación también puede depender de procesos de otro nivel superior, como la oración, que no se representa en la figura 12.
Como la información fluye de manera bidireccional, puede resolver ambigüedades o información parcial o degradada (en palabra escrita: estímulo confuso, faltante; en palabra hablada: por la velocidad del habla, coarticulación o, por ejemplo, un estornudo). Usa el contexto (las interconexiones entre unidades) y la influencia léxica para corregir interpretaciones erróneas en señales gráficas o acústicas incompletas o con ruido. Si se empieza a activar una palabra, esta facilita la posible detección de los fonemas compatibles e, incluso, que se “rellene” aunque no esté o esté degradada.
Los modelos tuvieron implementación computacional y pudieron simular, y por lo tanto dar cuenta de, numerosos efectos experimentales. En particular, de los efectos experimentales explicados previamente, el efecto de nivel de palabra sobre la percepción de fonemas. También explicaría los efectos en la decisión léxica. Las palabras frecuentes tendrían las conexiones facilitadas y, por lo tanto, es más rápida la decisión. Sobre el efecto de legalidad, múltiples conexiones inhibitorias entre fonemas impedirían la activación estable de una representación en el nivel léxico y tampoco habría activaciones fuertes en el nivel de palabra. Sobre el efecto de lexicalidad, las seudopalabras activarían partes de palabras, hasta que se llega al punto en que se rechaza que sean palabras, y esto consume tiempo. Es como si se recorriera el sistema léxico sin encontrar una activación suficiente, por lo que se responde no; esto consume más tiempo que la activación de una unidad léxica (respuesta “sí”) y también predice correctamente más errores que en los otros dos tipos de estímulos, por la activación parcial de entradas léxicas.
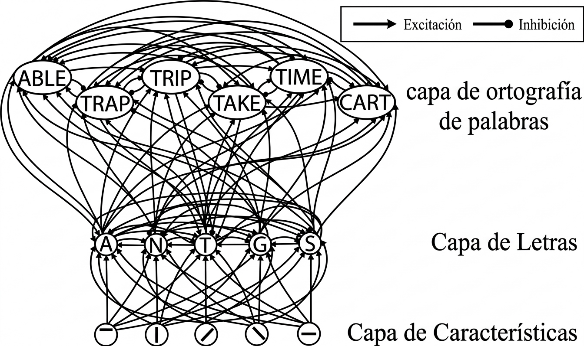
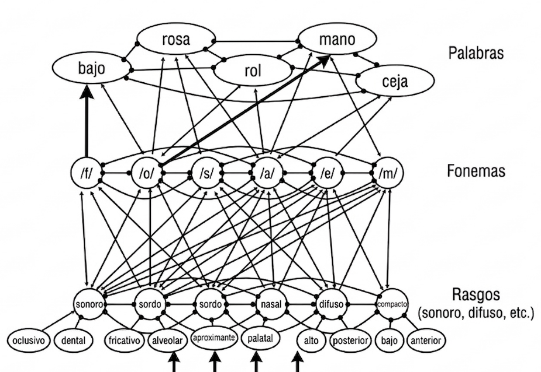
Figura 12. Modelos de procesamiento paralelo distribuido de palabra escrita (derecha) y hablada (izquierda).
Cabe agregar que estos modelos fueron una de las “cunas” de los actuales LLM, que aunque tienen grandes diferencias de arquitectura y capacidad de cómputo, reconocen a McClelland y Rumelhart entre sus precursores.
7.1.1. Acceso léxico: el lexicón
¿Qué es el componente o capa de “palabras”? La definición tradicional de lexicón o léxico mental lo describe como un almacén que contiene las palabras que una persona conoce (Cuetos et al., 2015; Molinari Marotto, 1998). Cómo se escribe (ortografía), cómo suena (fonología), información morfo-sintáctica (si es sustantivo, verbo, si es irregular, etc., y entonces qué funciones pueden tener en la oración). También tiene una dimensión semántica, en términos de semántica léxica, es decir, sus conexiones con otras entradas léxicas, con qué otras palabras se asocia. La semántica léxica se forma mediante relaciones sistemáticas entre las entradas léxicas, y es diferente de la semántica conceptual porque recoge solamente las asociaciones dadas por el lenguaje y no por esquemas conceptuales o de otras modalidades (Reilly et al., 2025; Urbaniak et al., 2025), como ya se discutió en este capítulo al respecto de los LLM. Según el paper de consenso de numerosos investigadores importantes en semántica léxica (Reilly et al., 2025) y la investigación neurocognitiva sobre la red de lenguaje (Urbaniak et al., 2025), así como desde otras perspectivas del debate, si bien se pueden separar a los fines de estudio, las relaciones o identidad entre distintos aspectos de la semántica (léxica, conceptual, corporeizada) son todavía un tema de investigación.
El lexicón se describe como un almacén a largo plazo, pero es parte del sistema de lenguaje. Es el conocimiento que un hablante tiene interiorizado del vocabulario, base de la capacidad de entender y utilizar unidades léxicas. Es aprendido y va creciendo a lo largo de la vida, de modo tal que las personas mayores tienen un tamaño del lexicón mayor que las personas jóvenes; también varía según las oportunidades educativas y culturales.
Las palabras que en general son más frecuentes (salvo excepciones) son las palabras de función, una clase cerrada y poco numerosa, que en general sirven para acompañar el significado de las otras palabras y establecer relaciones entre ellas. Por ejemplo, los artículos, preposiciones, conjunciones, demostrativos, auxiliares. En cambio, las palabras de clase abierta o de contenido (sustantivos, verbos, adjetivos, algunos adverbios) tienen significado por sí mismas y son la mayoría, miles o decenas de miles. En el léxico mental las dos clases de palabras estarían representadas de forma distinta: las palabras función, enteras, y las palabras de contenido estarían representadas por su raíz o lexema, junto con indicaciones de posibles variaciones si se unen con otros morfemas. Un resultado que avala esta idea es que el tiempo para decidir correctamente que no son palabras un tipo particular de seudopalabras compuesto por morfemas, p. ej. “floristero” o “panaderista”, es sumamente largo (Cuetos et al., 2015).
Tanto la evidencia experimental como en pacientes neuropsicológicos sugiere que no tenemos uno, sino varios lexicones, o al menos que la información del lexicón se encuentra parcialmente segregada. Una primera disociación sugerida por las afasias es entre un lexicón de entrada (para la comprensión) y un lexicón de salida (para la producción). Hay cuadros afásicos en los que la producción está afectada, pero la comprensión no, y viceversa. En el aprendizaje de una segunda lengua también tenemos la experiencia de entender algunas palabras que sin embargo no se nos ocurriría, no sabríamos cómo, usar en el habla. Otra disociación se encuentra en el acceso fonológico u ortográfico de una palabra (lo que se pide en la decisión léxica, ¿es o no palabra?) y el nivel semántico, el acceso a su significado. Por ejemplo, usted quizás puede decidir rápidamente que “hipérbole” o “catastro” son palabras, pero es más difícil dar una definición, qué quieren decir. En el caso de las dislexias, es posible que un paciente conozca la palabra y su significado, pero le sea difícil reconocerla visualmente en la lectura. Los modelos de lectura de palabras basados en patrones de pacientes, en neuropsicología cognitiva, distinguen un lexicón fonológico, un lexicón ortográfico y uno semántico, todos de entrada (lectura, comprensión), que a su vez podrían ser diferentes de los de salida. Así, en los modelos anteriores, donde se ubicó una capa de “palabras”, habría que distinguir distintos aspectos de las palabras y quizás postular distintos componentes o capas.
Por otro lado, el conocimiento semántico influye en el acceso léxico. Activar el significado de una palabra, sin verla, facilita su reconocimiento; no es simplemente un efecto de repetición. Esto se ve cuando se combina la decisión léxica con una tarea de priming semántico. En la presentación típica (hay otras), se presentan dos estímulos, en rápida sucesión. El primer estímulo es una palabra a la que no se tiene que dar respuesta o se tiene que hacer otra tarea; este estímulo es el prime o facilitador. Al ver el segundo estímulo, el participante tiene que realizar una decisión léxica (se presentan palabras y no palabras, aquí solo nos interesan las palabras). Por ejemplo, en la figura 13, hay que decidir si la palabra en minúscula es o no palabra (sí/no) e ignorar la palabra en mayúscula. Se varía sistemáticamente qué se presenta antes de la decisión léxica: pueden ser palabras con relación semántica fuerte (p. ej. “perro” antes que “gato”) o débilmente o no relacionadas (p. ej. “uvas”). El resultado típico es que el tiempo para decidir correctamente que “gato” es palabra es menor cuando la palabra que la precede (prime) tiene una relación semántica fuerte (“perro”) que cuando no la tiene (“uvas”). Por lo cual hay que suponer que la activación de la palabra “perro” pasó a “gato” en un nivel semántico, y esto facilita el acceso a la representación ortográfica de la palabra.
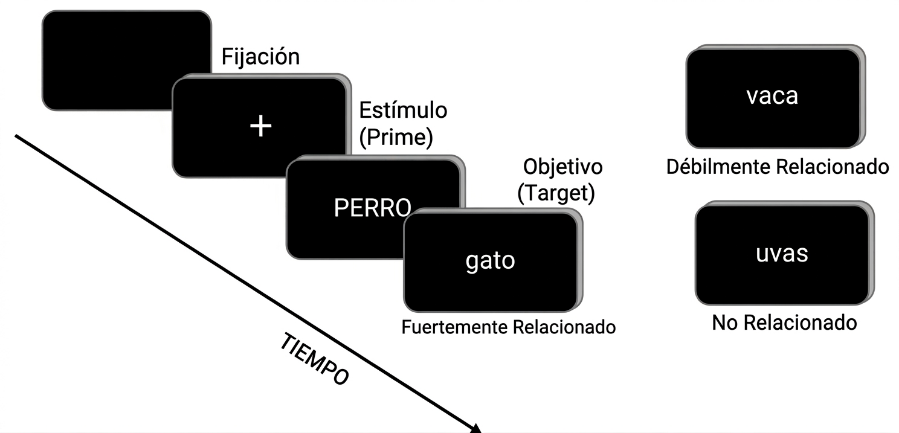
Figura 13. Priming semántico combinado con decisión léxica.
De hecho, los efectos de arriba abajo de influencia semántica no se limitan al nivel de la semántica léxica. También se pueden ver efectos del significado a nivel de la oración y posiblemente del discurso. En un experimento clásico, Swinney (1979) combinó priming semántico con decisión léxica. Pero en su caso, el priming semántico era una oración entera (versus una parte). Incluyó palabras polisémicas, es decir que tienen varios significados (p. ej. “banco”). En la parte de la decisión léxica se presentaban palabras que pertenecían al campo semántico de uno de los significados (p. ej. “plata”, de banco de dinero), versus palabras que correspondían al campo semántico de otro de los significados (p. ej. “plaza”, de banco para sentarse). La manipulación era mostrar previamente a la decisión léxica una parte de oración que no influía en el significado de la palabra polisémica (decisión léxica temprana), comparado con toda la oración, que decidía el significado de la palabra (decisión léxica tardía). Así, por ejemplo, algunos participantes tenían que decidir si “plata” o “plaza” era una palabra y antes veían “Fui al banco” (decisión temprana). En estos casos, había un efecto de priming sobre ambas, “banco” facilitaba ambas palabras relacionadas con los significados de banco. El tiempo de decisión era más rápido para “plata” y para “plaza” comparadas con otras, como “playa”. Pero cuando se presentaba la oración desambiguante (decisión léxica tardía), el grupo de participantes cuyo prime era “Fui al banco y deposité el cheque”, solo tenía una decisión léxica más rápida para “plata” y ahora “plaza” tenía un tiempo similar a “playa”. Un efecto opuesto se encontraba si la oración desambiguante era “Fui al banco y me senté a mirar las palomas”.
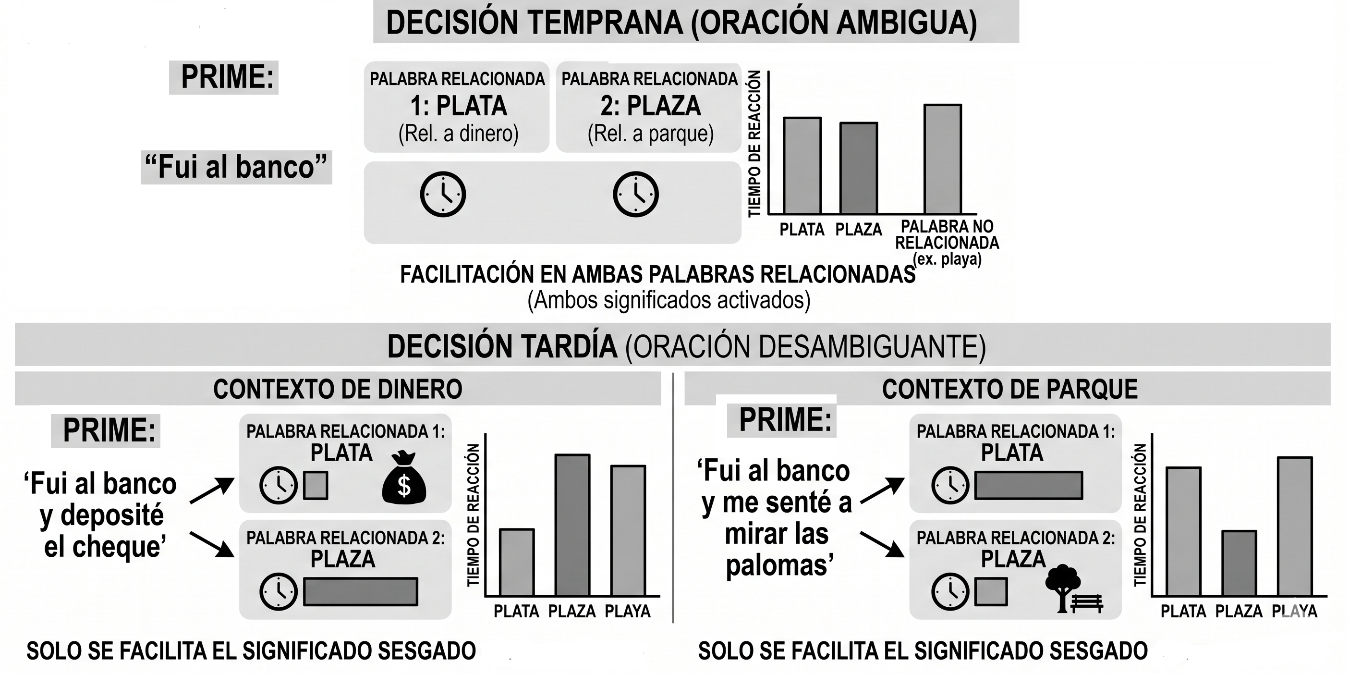
Figura 14. Priming semántico combinado con decisión léxica, nivel de oración.
Esto sugiere que sin un contexto desambiguante se activan todos los significados de la palabra polisémica, ya que hay un “desparramo”, una “propagación de activación” hacia palabras compatibles con todos los campos semánticos de la palabra polisémica, pero es extremadamente transitorio y en seguida interviene el contexto oracional desactivando los significados irrelevantes. El significado se estabiliza en el nivel de la oración y esto ejerce efectos de arriba abajo a las palabras que forman la oración. No es el significado de las palabras individuales y sus respectivos campos semánticos lo que domina, sino las relaciones entre los conceptos, las proposiciones, al nivel de la oración.
7.2. Procesamiento de discurso y texto
La comprensión a nivel del texto o discurso consiste en construir una representación integrada y coherente del conjunto de información, un modelo mental de lo que el texto o discurso refiere (Cuetos et al., 2015; Molinari Marotto, 1998). La comprensión no consiste simplemente en una colección de palabras u oraciones literales, sino en construir un modelo mental interno de lo que estoy leyendo o me están diciendo. Por supuesto, hay que comprender cada palabra aislada y cada oración, pero es mucho más que eso. Hay que resolver las relaciones entre las oraciones, extraer las ideas a las que se refieren y organizar las ideas en un modelo mental integrado. Por ejemplo, ¿de qué trata este capítulo? Si estuvo comprendiendo, la respuesta no es ir relatando cada oración en el orden en que las leyó, sino un resumen jerarquizado de las ideas: se trata de la comprensión del lenguaje, donde primero se explicó qué es el lenguaje y sus propiedades especiales y luego se expuso el campo de la psicolingüística; quizás puede dar más detalles de cada uno de los temas que se trató. Como se ve, el significado es un modelo mental de las ideas referidas en el conjunto de palabras y oraciones, unificado e integrado, ya que intenta contener todas las ideas; organizado, ya que jerarquiza los contenidos (ideas principales, secundarias, ejemplos…); y más duradero que el momento de la lectura o escucha, en el caso del discurso.
La construcción del modelo mental se realiza en la memoria de trabajo, a partir de los procesos de comprensión del lenguaje a nivel de palabra y oración, pero también de la atención y de la interacción con las memorias de largo plazo episódica y semántica, las cuales van a proveer el conocimiento necesario para ir construyendo ese modelo mental y para guardarlo posteriormente. Si es un texto o discurso que alude a personas, quizás intervenga el sistema de teoría de la mente para comprender intenciones y posturas personales. Si describe objetos o relaciones espaciales, también puede necesitar esquemas viso-espaciales. Así, el significado se construye a partir de capacidades y conocimiento extralingüísticos. Por ello, a diferencia de los procesos de más bajo nivel, en la comprensión a nivel de texto o discurso hay grandes diferencias entre las personas, e incluso en la misma persona, ya que puede no estar prestando atención, la memoria de trabajo puede estar ocupada en otra cosa, o puede carecer de los conocimientos necesarios para llevar a cabo la comprensión, entre otros factores que hacen a las diferencias individuales en comprensión de texto y discurso. Por ejemplo, no es lo mismo comprender en este capítulo los modelos de procesamiento del lenguaje si nunca tuvo un curso de psicología cognitiva o si no está prestando suficiente atención. Otro ejemplo es el que se expuso en el apartado 4.1.1. sobre la comprensión de GPT 3.5 en un texto que requería un conocimiento (bastante básico) sobre teoría de la mente.
7.2.1. Inferencias
Un texto o discurso es siempre “una guía incompleta hacia el significado” (Cuetos et al., 2015). Ningún discurso o texto se resuelve con la información explícita, sino que la persona tiene que reponer desde su conocimiento previo del lenguaje y de otros dominios. Este proceso de reponer información que no está explícita en el discurso o texto se llama realizar inferencias. Las inferencias en comprensión consisten en activar información que no está presente, no está explícita, en el texto o discurso (Molinari Marotto, 1998). Como destacan Cuetos et al. (2015) y León y Pérez (2003), hay que distinguir las inferencias en comprensión de las inferencias deductivas o inductivas en el razonamiento lógico, que son sistemáticas y dependen de procesos controlados de pensamiento. En cambio, las inferencias en comprensión consisten en la activación de conocimientos previos (lingüísticos, de memoria), y en gran medida es un proceso que no requiere consciencia o esfuerzo. Las inferencias pueden ocurrir durante la comprensión o durante la recuperación, es decir, cuando se recuerda después. Las primeras se consideran como fenómenos genuinos de procesamiento constructivo y las segundas reflejan también la elaboración, las fallas y distorsiones de la recuperación de la memoria, o conjeturas que las personas hacen acerca de lo que posiblemente escucharon o leyeron.
Esto se puede observar tanto en ejemplos de la vida cotidiana como en experimentos. Por ejemplo, alguien le cuenta: “¡Había estudiado bastante! Pero ese día no me sentí segura, repasaba y se me ponía la mente en blanco. Así que voy en otra fecha”. Se entiende que es alguien que iba a dar examen y que no lo rindió, aunque no dice “examen” ni “no lo rendí”. Son ideas que se activan desde su conocimiento previo para dar sentido al conjunto de la información explícita; a partir de información lingüística (especialmente “pero”, “así que”) y de su conocimiento previo sobre exámenes. Hay montones de ejemplos, porque de hecho en la comprensión cotidiana y en ámbitos profesionales, nos pasamos “rellenando” lo que nos dicen o leemos. Y no nos damos cuenta hasta qué punto esto es así, dado que es en gran medida una activación automática y no consciente. Para nosotros es lo que alguien dijo, pero no, es lo que nosotros inferimos a partir de lo que nos dijeron. Y estas inferencias reflejan no solo lo dicho, sino también, en gran medida, los conceptos y esquemas previos que tiene la persona que escucha o lee. Esto pone de manifiesto el gran salto (o abismo) que hay entre lo dicho explícitamente y lo que cada una de las personas entiende.
Las investigaciones experimentales sobre inferencias en este nivel emplean sobre todo estímulos escritos, textos. Una de las formas de estudiar inferencias es hacer preguntas sobre información literal e inferencial. Por ejemplo, en un estudio con niños entre 8 y 9 años, se presentaban pequeñas historias y luego se les hacía preguntas literales e inferenciales (Canet Juric et al., 2009). Una de las historias cuenta (entre otras cosas): “Cuando llegó estaba tan hambriento que se abalanzó sobre los estantes de la cocina y encontró galletitas. Como había jugado tan bien esa tarde, la mamá le preparó su comida favorita. Pero Juan no tenía hambre y ni siquiera tenía lugar para las papas fritas”. Luego, se pregunta a los niños: “¿Por qué Juan no estaba hambriento a la hora de cenar?”. Sin embargo, este tipo de investigación reflejaría más bien el producto del proceso de comprensión, lo que se logró una vez que se terminó de leer y se consulta la representación resultante.
Para detectar los procesos de comprensión mientras estos ocurren, lo que se suele hacer es elaborar textos pequeños en donde se hacen distintas variantes, se manipula experimentalmente alguna parte, en función de una hipótesis de procesamiento. Y se presenta el texto en una pantalla de computadora de a partes, por ejemplo, oración por oración (puede ser de a partes mayores o menores); se pide a la persona que vaya leyendo el texto en forma normal, pasando de pantalla con una tecla, y se toma el tiempo de lectura de la parte crítica, la que tiene la variación experimental. Por ejemplo, en una investigación sobre las inferencias espaciales (en una narración, ¿se representa de forma automática el espacio y los desplazamientos?) se presentaban historias como las de la figura 15. La persona iba leyendo las historias de a una o dos oraciones, algunas de las cuales presentaban una incongruencia espacial en la oración crítica. La tarea era responder (sí o no) a una pregunta general sobre el texto, para controlar la lectura en general, pero lo realmente importante era el tiempo de lectura de la oración crítica para la presentación congruente versus incongruente. El tiempo era más largo para las oraciones incongruentes, aunque las personas leían bastante rápido y, en general, como venían mezcladas con versiones congruentes y con otras historias que no tenían esta manipulación, no era algo que notaran conscientemente (algún participante comentó: “había algo raro en algunas historias”). No era algo que saltara obviamente a la vista. Sin embargo, en los resultados de muchos experimentos, sistemáticamente, el tiempo de lectura para la oración incongruente era más largo (décimas de segundo) que para la congruente, lo que muestra que efectivamente se realizaba la inferencia espacial, es decir, la mente detectaba que el personaje no estaba donde se supone que debía estar.
Lo mismo sucedía con historias con inferencias emocionales, donde se describía el aspecto, acciones y pensamientos de un/a protagonista, y la oración crítica decía “X estaba contento/enojado/triste/orgulloso/avergonzado…” de forma congruente o incongruente con las oraciones anteriores. El tiempo de lectura para la oración incongruente era mayor que para la oración incongruente, lo que muestra que los lectores activaban automáticamente la información sobre el estado emocional, aunque no se lo mencionara. De forma interesante, en pacientes con daño prefrontal ventro-medial, una región asociada a la regulación emocional y a la teoría de la mente, se observó el resultado típico para las inferencias espaciales, pero no para las inferencias emocionales (Burin et al., 2014).
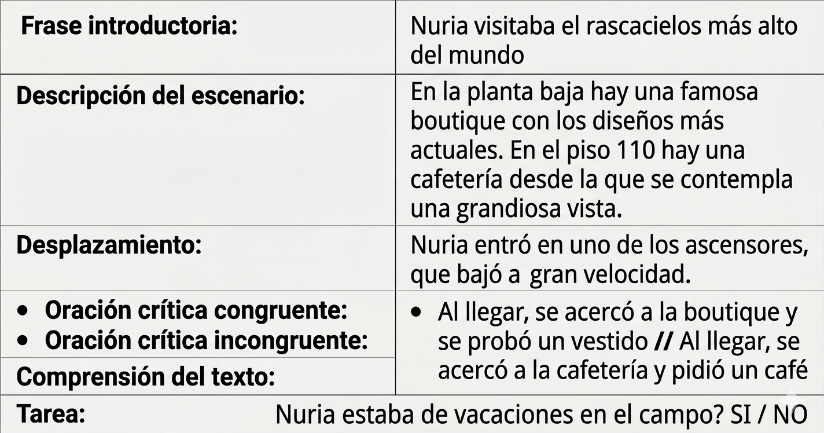
Figura 15. Ejemplo de tarea con tiempos de lectura, oración congruente/incongruente.
Los tiempos de lectura muestran el procesamiento cognitivo en distintos momentos de la lectura. También se puede ver cuando las personas que leen usan un dispositivo de seguimiento de fijaciones oculares (eye-tracking). Así, el tiempo de lectura es mayor, o las fijaciones de los ojos llevan más tiempo (o vuelven a un punto anterior de lectura), en las palabras que requieren procesos más complejos; por ejemplo, cuando se encuentra una palabra poco familiar, cuando se lee una oración gramaticalmente compleja o cuando se realiza una inferencia. Asimismo, se puede combinar el uso de técnicas ya presentadas, como detección, decisión léxica o denominación, con el contexto de un texto en diferentes puntos de este, para investigar procesos y representaciones durante la comprensión.
¿Qué tipos de inferencias se realizan en la comprensión? Según León y Pérez (2003), hay diversas formas de clasificarlas, de acuerdo con distintos criterios. Entre ellos, respecto de lo que se estuvo presentando, se pueden destacar los siguientes:
- Según el curso temporal o momento en que se realiza la inferencia: en el mismo momento de la comprensión, mientras se escucha o lee, se llaman inferencias online, en curso o constructivas; si son posteriores al momento de la comprensión, se denominan inferencias offline, a posteriori o reconstructivas.
- Según los recursos cognitivos implicados, son automáticas, no conscientes, sin consumir recursos de la memoria de trabajo y rápidas; o estratégicas (o elaborativas), que requieren mayor esfuerzo de procesamiento, estrategias de pensamiento o recuperación y llevan más tiempo.
- Según el contenido de la información que tratan, pueden ser espaciales, temporales, causales, instrumentales, de estado psicológico, etc.
- Según el aspecto o fenómeno emergente del texto o discurso que resuelvan, es decir, si están destinadas a resolver la cohesión o coherencia local, o a construir la coherencia global.
7.2.2. Cohesión y coherencia
Para construir el modelo mental hay que resolver dos aspectos principales: la cohesión o coherencia local y la coherencia o coherencia global. Son los fenómenos emergentes en el nivel de texto o discurso, los cuales requieren inferencias (Cuetos et al., 2015; León & Pérez, 2003; Molinari Marotto, 1998).
Construir la cohesión, también llamada coherencia local, implica entender la continuidad referencial y temática entre las oraciones. Cómo se “pega”, cómo se relaciona una oración con alguna oración anterior. Las inferencias que contribuyen al establecimiento de la coherencia local establecen una conexión o “puente” entre dos frases, tratando de unir la información que en ese momento se está leyendo con otra previa. Por eso también se llaman inferencias locales, conectivas o puente. La coherencia local entre contenidos próximos en el texto o discurso suele estar guiada por la presencia de marcadores de cohesión, como anáforas y conectores.
Las anáforas consisten en un elemento lingüístico cuya interpretación depende de otro anterior. Son palabras o conjuntos de palabras que sustituyen un término que ya se mencionó por otro, como pronombres, posesivos, indefinidos o construcciones nominales. Establecen la referencia conjunta, la correferencia. Por ejemplo, para comprender de forma unificada estas dos oraciones: “María le dio dinero a Juana. A ella no le gusta que sus amigas estén en problemas”, hay que resolver “ella” y “sus”. En este caso, la resolución de la cohesión depende enteramente del conocimiento lingüístico, entender “ella” y “sus”. En otros casos depende del conocimiento previo almacenado de la persona que comprende. Por ejemplo, para las siguientes oraciones: “Piaget y Chomsky debatieron sobre el origen ontogenético del lenguaje. Para el lingüista, el lenguaje es innato”, es necesario saber cuál de ambos autores es “el lingüista”. La coherencia local de oraciones contiguas es también favorecida por el hecho de que los contenidos vinculados pueden estar coactivados en la memoria de trabajo.
Los conectores son palabras o conjuntos de palabras que enlazan y señalan relaciones entre oraciones y párrafos. Suelen ser conjunciones (“y”, “o”, “pero”, “aunque”…), adverbios o construcciones de adverbio (“además”, “sin embargo”, “no obstante”, “finalmente”, “luego”…). Los conectores, según su función, pueden ser causales, consecutivos, aditivos, adversativos, temporales, entre otros. En el ejemplo ya citado, “¡Había estudiado bastante! Pero ese día no me sentí segura, repasaba y se me ponía la mente en blanco”, al leer “pero” se infiere que lo que se lee a continuación es contrario a lo que se leyó antes (conjunción adversativa). Los conectores requieren del conocimiento de la lengua. Por ejemplo, no es lo mismo “luego” usado de forma temporal que de forma causal.
La cohesión es condición necesaria pero no suficiente para la coherencia global. Un discurso o texto puede ser seudocoherente: podemos establecer la correferencia entre una oración y la anterior, pero el conjunto del discurso o texto no tiene un sentido unificado, integrado. Por ejemplo, en este texto: “Mi animal favorito es el gato. Estos fueron domesticados hace casi 10.000 años en la antigua Mesopotamia. El nombre de esta región significa ‘la tierra entre dos ríos’ en griego. Entre las más antiguas versiones de la Biblia hay una en esa lengua”, se puede ir resolviendo el referente de cada oración en la anterior (“estos”, “esta región”, “una”), pero el conjunto carece de unidad, de coherencia global.
La coherencia de un texto o discurso implica derivar un sentido global, unificado, integral; extraer las ideas del texto o discurso y cómo se organizan entre sí. Como se dijo antes, esto depende de procesos a nivel de palabra y oración y del establecimiento de la cohesión; también de la atención, la memoria de trabajo, el conocimiento previo en distintos dominios. Las inferencias que activan o añaden información para lograr esto se llaman inferencias globales o elaborativas. En uno de los ejemplos ya citados, “¡Había estudiado bastante…”, entender que iba a rendir un examen es una inferencia global. En otro de los ejemplos, “María le dio dinero a Juana. A ella no le gusta que sus amigas estén en problemas”, podría ser la idea de que Juana tiene una deuda.
La importancia de la coherencia global, la capacidad de formarse un modelo mental integrado de lo que se escucha o lee, fue puesta de manifiesto en un estudio clásico de Bransford y Johnson (1972, en Cuetos et al., 2015, p. 233), en donde se presentaban textos como el siguiente, con o sin el título:
“La orilla del mar es mejor sitio que una calle. Al principio es mejor correr que caminar. Puede que tengas que intentarlo varias veces. Requiere bastante habilidad, pero es fácil de aprender. Incluso los niños pueden disfrutar con ello. Si tienes éxito, las complicaciones son mínimas. Los pájaros rara vez se acercan. Con la lluvia, sin embargo, se empapa rápidamente. Si hay mucha gente haciendo lo mismo esto puede causar problemas. Uno necesita mucho espacio. Si no hay complicaciones, es una actividad agradable. Una piedra puede servir como anclaje. Sin embargo, si se suelta no tendrás una segunda oportunidad”.
Las personas que leyeron el texto con el título comprendieron mejor y juzgaron que habían comprendido mejor los textos que los que no vieron el título. Y también recordaron más contenidos en preguntas posteriores. Por cierto, el título del texto es: “Volando una cometa (barrilete)”.
Otra de las fuentes para poder derivar la coherencia, la organización de las ideas, es el tipo de texto o discurso, siendo la principal distinción entre texto narrativo y expositivo, que corresponden a dos formas típicas del pensamiento y de la comunicación humana. Los textos narrativos se definen por la descripción de situaciones y episodios, centran su núcleo en el desarrollo de una secuencia de acciones. Por el contrario, los textos expositivos se enfocan en la presentación de ideas, argumentos, demostraciones, y priorizan la transmisión de información sobre el relato de sucesos. En cuanto al contenido, el texto narrativo describe episodios que incluyen a personas que interactúan entre sí, tienen intenciones y metas, afrontan problemas u obstáculos, sienten emociones, etc. El texto expositivo generalmente se refiere a conocimientos técnicos, científicos, sociales o argumentos (manuales, tratados, artículos, ensayos, etc.). En cuanto a la organización, el texto narrativo tiene un ordenamiento espacial, temporal, causal y motivacional, donde los hechos se encadenan según una cronología o una lógica de causa y efecto. La exposición emplea una organización conceptual o lógica, estructurando el contenido para facilitar el análisis o la comprensión de un tema específico mediante jerarquías de pensamiento. Respecto de la intención comunicativa, el texto narrativo busca relatar, interesar, entretener, emocionar; el texto expositivo estaría orientado a explicar, enseñar, informar o persuadir.
Poseer un esquema mental genérico sobre el tipo de discurso o texto con que se interactúa ayuda a organizar la coherencia global y guía las inferencias. Si la persona escucha o lee una narración, en su mente tenderá a organizar la información en un esquema canónico o típico, que consta de los siguientes elementos y organización (Molinari Marotto, 1998): marco, tema, trama, resolución. La información del marco establece el tiempo, lugar y personajes principales. El tema es el foco general que guía la trama, un objetivo que el personaje principal debe alcanzar o un conflicto principal. La meta o conflicto puede presentarse por una secuencia de sucesos que lo justifican. La trama de la historia comprende un número indefinido de episodios, cada uno de los cuales comprende intentos de alcanzar submetas u objetivos parciales, o avances o retrocesos en el conflicto. Los episodios pueden incrustarse unos en otros y producir una jerarquía de eventos en la representación de la historia. La resolución es la respuesta de la historia con respecto al tema. Por ejemplo, en la literatura o el cine hay un recurso estilístico de comenzar la historia en algún punto de la trama, en un episodio intermedio, y la narración puede ir atrás o adelante sin aclarar mucho. Nuestra mente intentará, automáticamente, ubicar cuáles son los personajes principales (y secundarios) y el escenario, cuál es el conflicto principal, qué pasó primero y qué después, cómo se llegó al momento que estamos viendo o leyendo.
Las narraciones son la forma más frecuente y temprana de discurso. En cambio, el texto expositivo es una forma más artificial, un “producto cultural” (Cuetos et al., 2015) y, por lo tanto, requiere mayor entrenamiento o contacto explícito para interiorizar su esquema básico. Tienen en común que exigen identificar ideas principales, secundarias y otros niveles jerarquizados. Exigen distinguir cuáles son los elementos de información principales y cómo se interrelacionan. Sin embargo, dentro de esta categoría se pueden encontrar distintos esquemas. Una descripción expone las características, propiedades o atributos de un objeto, fenómeno o concepto; su estructura suele ser jerárquica, partiendo de una idea general hacia detalles específicos (por ejemplo, este capítulo). Un texto sobre causalidad explica el funcionamiento de un sistema, máquina o proceso; suele describir los componentes de manera secuencial y la interacción entre ellos para lograr un resultado determinado (por ejemplo, la descripción de los modelos de procesamiento de palabra, en este capítulo). Una variante de texto de causalidad es la de multicausalidad, que identifica y analiza las variables, causas o elementos que inciden en la aparición o desarrollo de un fenómeno. En general, a medida que la persona se hace experta en una disciplina, adquiere en su mente el tipo de texto específico de esta. Por ejemplo, un tipo de texto que ayuda mucho en las disciplinas científicas es la estructura de un paper (resumen, introducción, método incluyendo participantes, materiales y procedimiento, resultados, conclusiones). Una vez interiorizada esta estructura y qué esperar en cada apartado, se facilita la comprensión de los artículos científicos.
Otro tipo de texto que no debería confundirse con los anteriores es el texto argumentativo/persuasivo. Su función no es relatar ni explicar, sino convencer. Puede incluir narraciones o explicaciones, pero al servicio de persuadir o influir en el pensamiento sobre determinado tema. Su estructura debe organizarse en términos de tesis o idea principal, argumentos a favor y argumentos en contra que se intentan derribar o desestimar.
La educación formal tiene un papel importante en la adquisición del conocimiento de los tipos de texto. Es necesario el contacto con distintos tipos de texto, su estructura y su función, para que las personas internalicen y luego empleen este conocimiento a la hora de comprender. Si una persona no encuentra discursos y textos expositivos variados en su educación formal (o informal, en su defecto), si no puede darse cuenta de las diferencias en los tipos de discursos o textos, frente a una clase o texto de nivel universitario, el esfuerzo por organizar la información entrante y activar inferencias será mayor y, por lo tanto, la comprensión se hará más difícil.
La investigación sobre comprensión de discurso y texto es muy amplia, en este capítulo solo se ha intentado una introducción. Se puede profundizar en numerosos modelos propuestos para dar cuenta de cómo es la dinámica del procesamiento durante la comprensión, y en particular qué tipo de representaciones mentales se forman en distintos momentos de la comprensión (Cuetos et al., 2015). Otras investigaciones se centran en la influencia e interacción con sistemas y procesos de la memoria de trabajo, de la atención, de la recuperación episódica, y con procesos emocionales y motivacionales. Asimismo, las teorías e investigaciones sobre comprensión han sido relevantes para la investigación y la aplicación práctica en áreas diversas, que van desde la comprensión por parte de sistemas computacionales hasta la psicología de la instrucción y educacional.
8. Procesamiento en producción del lenguaje
El procesamiento en producción del lenguaje comprende representaciones y procesos, a diferente nivel, que hacen que la gente exprese sus ideas por medio de sonidos (habla) o trazos gráficos (escritura). Como la comprensión, esto se realiza de forma rápida, automática y, en gran medida, no consciente; y, como en el caso anterior, se han propuesto modelos (Cuetos et al., 2015; Meyer et al., 2019).
Los estudios sobre producción han analizado errores y pausas en discurso libre o en tareas de denominación o descripción de imágenes (por ejemplo, un objeto o una acción, “las abejas pican al hombre”). En estas tareas también se toma el tiempo de nombrado, y se encuentran efectos similares a los de comprensión (por ejemplo, efectos de frecuencia). Evidencia convergente proviene de pacientes neuropsicológicos y, más recientemente, de modelos computacionales.
La producción se inicia con una serie de ideas o significados en el marco de una intención comunicativa (niveles semántico y pragmático), que a su vez se nutren de otros sistemas cognitivos. Ese mensaje inicial tiene que ser transformado a una forma verbal para que pueda ser comunicable a través del lenguaje. Por un lado, hay que seleccionar las palabras que se corresponden con los conceptos que se quiere transmitir y, por otro lado, hay que implementar esas palabras en oraciones gramaticalmente aceptables dentro de su lengua. Estos son los niveles léxico y sintáctico-gramatical, respectivamente. En la formación de la oración se deben flexionar las palabras de acuerdo con reglas morfológicas, en la interfase entre el procesamiento léxico y el sintáctico. Así se obtiene una sucesión de palabras en una oración. En la producción oral, esta cadena se tiene que implementar en una serie de sonidos del lenguaje (nivel fonológico), con una melodía y entonación de la frase adecuada (nivel prosódico). En la producción escrita se deberá acceder a la ortografía. Finalmente, las secuencias anteriores se implementan en un plan motor, que genera la conducta vocal o manual. El estudio se ha centrado sobre todo en el habla, y en menor medida en escritura y lengua de señas, donde los procesos centrales parecen ser los mismos, con variaciones en las etapas finales de programación motora. La figura 16 grafica, a grandes rasgos, el proceso. Los primeros modelos eran modularistas, luego se reformularon como modelos conexionistas (Griffin, 2024).
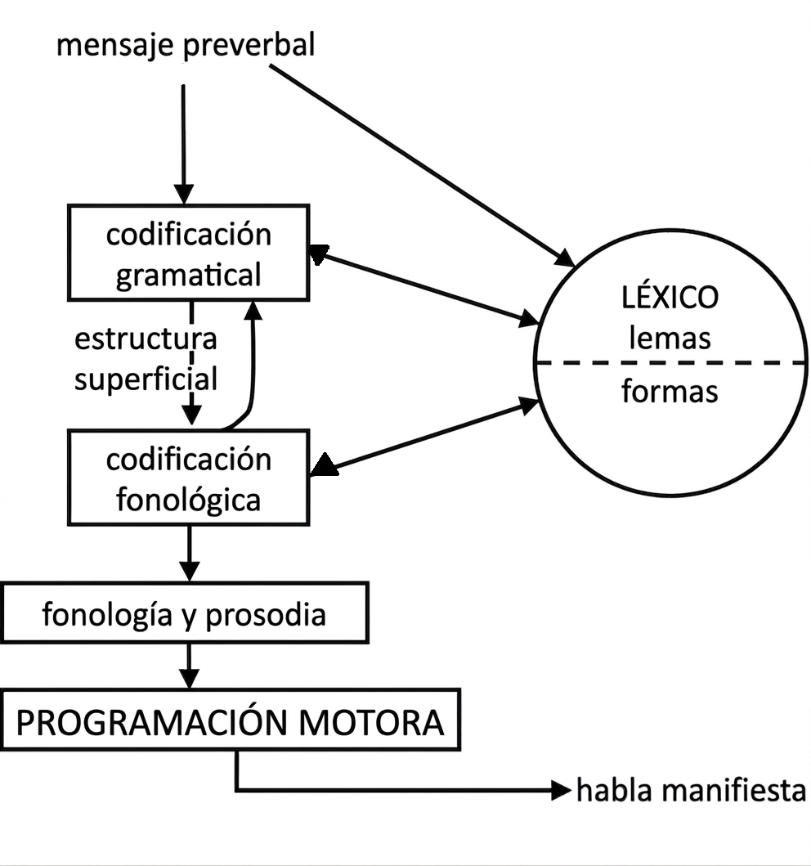
Figura 16. Procesamiento en producción del lenguaje oral.
8.1. Interacción entre sintaxis y léxico
¿Qué va antes: la selección léxica o la estructura sintáctica? Según Cuetos et al. (2015), habría una interacción entre ambos componentes, se realizan en paralelo. La estructura sintáctica consiste en proyectar relaciones conceptuales en estructuras sintácticas, es decir, identificar agente (sujeto), acción (verbo), objeto, etc. A esto le corresponderían categorías de palabras (sustantivos, verbos, etc.). La principal evidencia de un “corsé sintáctico” es que en la mayoría de errores de habla (los “lapsus”) la palabra errónea pertenece a la misma categoría gramatical que la palabra pretendida. Por ejemplo, un sustantivo por otro sustantivo, un verbo por otro verbo.
Por otro lado, es imposible planificar una estructura sintáctica sin tener ningún conocimiento de cuáles son los elementos léxicos. Y estos, especialmente los verbos, rigen determinadas construcciones, “vienen con la estructura puesta”. Por ejemplo, el verbo “dar” implica que alguien (sujeto) da algo (objeto directo) a alguien (objeto indirecto). Si se activa ese verbo en el lexicón, ya viene con esa estructura, va a exigir una estructura sintáctica (aunque luego, por ejemplo, pueda estar tácito el sujeto). Según Cuetos et al. (2015), todos los verbos transitivos (“tener”, “comprar”, “hacer”, etc.) presuponen un objeto directo, mientras que los intransitivos (dormir, entrar, ayudar, etc.) no llevan objeto directo. Otros llevarían circunstancial de lugar (por ejemplo, “entrar”). Entonces, se sugiere una activación paralela e interactiva: al mismo tiempo que se está organizando la oración, se van seleccionando palabras que determinan una estructura sintáctica, en un proceso de mutua constricción. Mientras ocurre este proceso la oración está “abierta”, como sugiere el hecho de que los errores de habla pueden ocurrir entre palabras de sintagmas distintos, de distintas partes de la oración. Por ejemplo, “tu coche se queda sin su padre” en lugar de “tu padre se queda sin su coche” (Cuetos et al. 2015). Si fuera que primero se realiza la codificación sintáctica y luego se insertan las palabras, no habría el intercambio entre sujeto y objeto directo.
Se va generando tanto el orden de los elementos de la oración y de las palabras como la flexión correcta de las palabras. Es también en la interacción de sintaxis con léxico que las palabras toman su forma flexionada, es decir, se pasa de una representación de palabra más abstracta (el lema) a su forma final.
8.2. Selección léxica
Los errores en producción más comunes son sustituciones semánticas (“foxterrier” por “labrador”) o fonológicas (“lavador”) (Griffin, 2024). El modelo sobre procesamiento léxico en producción plantea, luego del nivel conceptual, dos niveles de representación léxica: el lema y la forma fonológica (en Cuetos et al., 2015; Griffin, 2024). El nivel de lema contiene el lexicón (de salida), donde se representan diferentes aspectos de las palabras como unidades independientes de la modalidad, propiedades como la clase gramatical (sustantivo, verbo, etc.), sus correspondientes variaciones posibles y su conexión con el significado conceptual. En el fenómeno de la palabra “en la punta de la lengua”, cuando el hablante sabe lo que quiere decir pero no le sale la palabra, se suele conocer información gramatical. Por ejemplo, si no le sale la palabra “birome” sabría que tiene género gramatical femenino (“me pasás la…”).
La forma fonológica (a veces llamada lexema) es la secuencia de fonemas, es decir, incluye las formas finales, flexionadas, de las palabras. Se almacenan temporalmente fragmentos de planes fonéticos, posiblemente en fragmentos morfológicos de las palabras, a medida que se genera la secuencia correcta. Los errores fonológicos implican la selección de la palabra correcta según su significado, pero una recuperación fonológica errónea. Si la recuperación se produjera en una sola etapa, no cabría esperar que los errores se dividieran tan claramente en tipos semánticos y fonológicos. En escritura constaría de la forma ortográfica, cuyos errores también son independientes de la semántica.
El modelo conexionista de producción de palabras propone tres capas de unidades o nodos de acuerdo con el nivel de representación: conceptual, de palabra (lema) y de forma fonológica. Como en los modelos de comprensión, hay densas interconexiones de procesamiento en paralelo de activación e inhibición, y competencia intranivel. En estudios de denominación de imágenes, cuantas más palabras haya asociadas a un concepto, mayor es el tiempo de nombrado (Griffin, 2024).
En el modelo se distingue la generación de secuencias de representaciones fonológicas abstractas de la de una secuencia fonética específica, que tiene en cuenta la entonación y la melodía, es decir, la prosodia. Esta distinción se basa tanto en análisis acústicos como de los errores. En este punto las unidades relevantes serían las sílabas, así como aspectos pragmáticos de entonación.
8.3. Otras investigaciones
En esta breve introducción al estudio de la producción del lenguaje se han dejado de lado, como en la presentación sobre comprensión, interesantes investigaciones sobre modelos específicos de la dinámica de la producción, de la interacción con otros dominios cognitivos y del estudio de la escritura y sus alteraciones.
En la combinación del estudio de comprensión y producción también hay temas donde se han generado avances significativos, como el estudio de personas bilingües y el estudio de la conversación entre dos o más personas y los fenómenos emergentes.
Este capítulo es a la vez una introducción y una invitación a profundizar en temas de su interés.
Referencias
Austin, J. (1970). ¿Cómo hacer cosas con palabras? Buenos Aires: Paidós.
Bender, E., Gebru, T., McMillan-Major, A., & Shmitchell, S. (2021). On the dangers of stochastic parrots: Can language models be too big? FAccT ’21: Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency, 610-623. https://doi.org/10.1145/3442188.3445922.
Bruner, J. S. (1986). El habla del niño: aprendiendo a usar el lenguaje. Barcelona: Paidós.
Burin, D. I., Acion, L., Kurczek, J., Duff, M. C., Tranel, D., & Jorge, R. E. (2014). The role of ventromedial prefrontal cortex in text comprehension inferences: semantic coherence or socio-emotional perspective? Brain and Language, 129, 58-64. https://doi.org/10.1016/j.bandl.2013.12.003.
Canet-Juric, L., Urquijo, S., Richard’s, M., & Burin, D. (2009). Cognitive predictors of reading comprehension levels using discriminant analysis. International Journal of Psychological Research, 2(2), 99-111. https://doi.org/10.21500/20112084.865.
Chomsky, N. (1957). Syntactic structures. Mouton.
Chomsky, N. (1959). Review of Skinner’s Verbal Behavior. Language, 35, 26-58.
Cuetos, F., González, J., & de Vega, M. (2015). Psicología del lenguaje. Madrid: Editorial Médica Panamericana.
De Saussure, F. (1985). The linguistic sign. In R. Innis (Ed.), Semiotics: An introductory anthology. Bloomington: Indiana University Press.
Eimas, P. D. (1996). The perception and representation of speech by infants. En J. L. Morgan & K. Demuth (eds.). Signal to Syntax. Mahwah, N. J.: Erlbaum.
Fedorenko, E., Ivanova, A. A., & Regev, T. I. (2024). The language network as a natural kind within the broader landscape of the human brain. Nature Reviews. Neuroscience, 25(5), 289-312. https://doi.org/10.1038/s41583-024-00802-4.
Gallego López, C. (1995). Lenguaje. En A. Puente Ferreras (Ed.), Psicología básica. Introducción al estudio de la conducta humana (pp. 365-416). Madrid: Pirámide.
García Vega, L. (1993). Reflexiones sobre el condicionamiento de Pavlov a la luz de la psicología cognitiva. Revista de Historia de la Psicología, 14 (3-4), 341-346. https://journals.copmadrid.org/historia/art/1f1baa5b8edac74eb4eaa329f14a0361.
Gordon, P. (2004). Numerical cognition without words: Evidence from Amazonia. Science, 306(5695), 496-499. https://doi.org/10.1126/science.1094492.
Griffin, Z. M. (2024). Language Production. In M. C. Frank & A. Majid (Eds.), Open Encyclopedia of Cognitive Science. MIT Press. https://doi.org/10.21428/e2759450.b076f599.
Hall, M. L., Hall, W. C., & Caselli, N. K. (2019). Deaf children need language, not (just) speech. First Language, 39(4), 367-395. https://doi.org/10.1177/0142723719834102.
Jackendoff, R. (2002). Foundations of language: Brain, meaning, grammar, evolution. Oxford University Press.
León, J. A., & Pérez, O. (2003). Taxonomías y tipos de inferencias. En J. A. León (Coord.), Conocimiento y discurso: Claves para inferir y comprender (pp. 45-66). Madrid: Pirámide.
Lupyan, G., Gentry, H., & Zettersten, M. (2026). How important is language for human-like intelligence? Perspectives on Psychological Science, 21(1), 115-120. https://doi.org/10.1177/17456916251398539.
McClelland, J. L., & Elman, J. L. (1986). The TRACE model of speech perception. Cognitive Psychology, 18(1), 1-86. https://doi.org/10.1016/0010-0285(86)90015-0.
McClelland, J. L., & Rumelhart, D. E. (1981). An interactive activation model of context effects in letter perception: I. An account of basic findings. Psychological Review, 88(5), 375-407. https://doi.org/10.1037/0033-295X.88.5.375.
Mehler, J., Dommergues, J. Y., Frauenfelder, U., & Segui, J. (1981). The syllable’s role in speech segmentation. Journal of Verbal Learning & Verbal Behavior, 20(3), 298-305. https://doi.org/10.1016/S0022-5371(81)90450-3.
Molinari Marotto, C. (1998). Introducción a los modelos cognitivos de la comprensión del lenguaje. Buenos Aires: Eudeba.
Piaget, J. (1976). El lenguaje y el pensamiento en el niño (4.ª ed.). Buenos Aires: Guadalupe.
Piaget, J. (1995). Comentario sobre las observaciones críticas de Vigotsky. En L. S. Vigotsky, Pensamiento y lenguaje. Buenos Aires: Ediciones Fausto. Original: 1962.
Pinker, S. (1996). El instinto del lenguaje. Cómo crea el lenguaje la mente. Madrid: Alianza Editorial.
Pinker, S. (2003). Language as an adaptation to the cognitive niche. In M. H. Christiansen & S. Kirby (Eds.), Language evolution (pp. 16-37). Oxford University Press. https://doi.org/10.1093/acprof:oso/9780199244843.003.0002.
Pinker, S., & Jackendoff, R. (2005). The faculty of language: What’s special about it? Cognition, 95(2), 201-236. https://doi.org/10.1016/j.cognition.2004.08.004.
Prinzmetal, W. (1992). The word-superiority effect does not require a T-scope. Perception & Psychophysics, 51(5), 473-484. https://doi.org/10.3758/bf03211643.
Reilly, J., Shain, C., Borghesani, V., Kuhnke, P., et al. (2025). What we mean when we say semantic: Toward a multidisciplinary semantic glossary. Psychonomic Bulletin & Review, 32(1), 243-280. https://doi.org/10.3758/s13423-024-02556-7.
Resches, M., Querejeta, M., Laguens, A., Aquino, C., Kohan-Cortada, A., & De Grandis, M. (2024). Asistencia a jardín maternal, educación materna y habilidades lingüísticas tempranas en niños y niñas argentinos. Revista de Psicología, 42(2) (2024), 1210-1247. https://doi.org/10.18800/psico.202402.019.
Rumelhart, D. E., & McClelland, J. L. (1982). An interactive activation model of context effects in letter perception: II. The contextual enhancement effect and some tests and extensions of the model. Psychological Review, 89(1), 60-94. https://doi.org/10.1037/0033-295X.89.1.60.
Schüle, M. (2025). On the semantics of Large Language Models. In A. Gefen & P. Huneman (Eds.), Philosophies of AI: thinking and writing with LLMs, Intellectica, 81, pp. 15-36. https://doi.org/10.48550/arXiv.2507.05448 [preprint version].
Skidelsky, L. (2023). Pensamiento y lenguaje. En L. Skidelsky (Ed.), Introducción a la filosofía de las ciencias cognitivas (pp. 335-358). Bogotá: Ediciones Uniandes. https://doi.org/1o.51573/Andes.9789587985191.97895879852o7.
Strachan, J. W. A., Albergo, D., Borghini, G., et al. (2024). Testing theory of mind in large language models and humans. Nature Human Behaviour, 8(7), 1285-1295. https://doi.org/10.1038/s41562-024-01882-z.
Tomasello, M. (2023). Social cognition and metacognition in great apes: a theory. Animal Cognition, 26, 25-35. https://doi.org/10.1007/s10071-022-01662-0.
Ullman, T. (2023). Large Language Models fail on trivial alterations to theory-of-mind tasks. Arxiv: Computer Science, Artificial Intelligence. https://doi.org/10.48550/arXiv.2302.08399.
Urbaniak, M., Paczyńska, M., Caramazza, A., & Bola, L. (2025). Neural representation of nouns and verbs in congenitally blind and sighted individuals. Nature Communications, 16(1), 8090. https://doi.org/10.1038/s41467-025-63423-0.
Van Leeuwen, E., Bryon, E., Rogers, A., Balaran, A., Motsch, P., & Brooker, J. (2025). Chimpanzees socially learn non-instrumental behaviour from conspecifics. Behaviour, 162(6-8), 459-476. https://doi.org/10.1163/1568539X-bja10313.
Vigotsky, L. (1995). Pensamiento y lenguaje. Buenos Aires: Ediciones Fausto. Manuscrito original: 1934.
